
一、 项目介绍
MAX32655FTHR 基于 MAX32655 低功耗双核微控制器,内部集成 Arm Cortex-M4F 与 RISC-V 两个处理核心,并支持 Bluetooth 5.2 Low Energy。其双核架构能够将应用处理与蓝牙无线侧任务进行分工,并通过 Mailbox 完成核间命令、事件和状态交换,适合低功耗无线感知与可穿戴设备开发。
本项目在 MAX32655FTHR 基础上扩展多类传感器、LoRa 远距离通信和外部 SPI Flash,构建一套集多传感感知、双核 BLE、远距离通信、Edge AI 与无线升级于一体的智能感知终端。系统利用 BLE 完成近距离配置和实时数据交互,利用 LoRa 完成远距离状态与事件上报,并尝试在 Cortex-M4F 上部署轻量化模型,实现端侧数据分析和本地响应。
项目目标:
- 双核协同 BLE: Cortex-M4F 负责应用逻辑与数据处理,RISC-V 负责 BLE 底层无线任务,通过 Mailbox 实现双向命令、事件和状态同步。
- 多传感感知: 接入 IMU、环境、磁场及 8×8 ToF 等传感器,实现运动、环境和空间信息采集。
- LoRa 远距通信: 通过 UART 接入 433 MHz LoRa 模块,实现设备状态和关键事件的远距离无线传输。
- Edge AI: 在端侧进行轻量化模型推理,实现传感数据的本地识别、状态判断和事件触发。
- BLE OTA: 通过 BLE 接收固件镜像,并利用外部 W25Q SPI Flash 暂存升级数据,为 Bootloader 固件更新提供支持。
二、设计思路
本项目以“感知—处理—通信—维护”为总体设计主线。系统首先通过 IMU、环境传感器和 ToF 等器件获取运动、环境与空间信息,由 Cortex-M4F 完成数据采集、处理及上层应用逻辑;同时利用 MAX32655 的 RISC-V 核承担 BLE Controller 与无线侧时序任务,两个核心通过 Mailbox 交换命令、数据和状态,实现应用处理与无线通信的分工协作。
通信部分采用 BLE + LoRa 双无线架构。BLE 主要用于近距离设备连接、实时数据交互和 OTA 升级;LoRa 通过 UART3 与主控连接,用于 433 MHz 远距离状态遥测和关键事件上报。两种无线方式分别面向不同距离和数据量需求,避免单一通信方式兼顾所有场景。
在数据处理方面,传感器数据经过采集、滤波和必要的特征处理后,可进一步送入轻量化 Edge AI 模型进行本地推理,并根据识别结果触发本地响应、BLE 数据更新或 LoRa 事件上报。系统同时使用板载 W25Q SPI Flash,用于模型、OTA 镜像等数据存储,使设备具备后续升级和功能扩展能力。
整体设计重点如下:
- 双核分工: M4 负责应用与数据处理,RISC-V 负责 BLE 无线任务,通过 Mailbox 建立双核协同闭环。
- 双无线互补: BLE 面向近距离交互,LoRa 面向远距离遥测和事件上报。
- 端侧处理: 尽量在设备本地完成数据分析和状态判断,只上传必要结果。
- 可维护性设计: 利用 BLE OTA 与外部 SPI Flash,实现固件暂存、验证和后续更新。
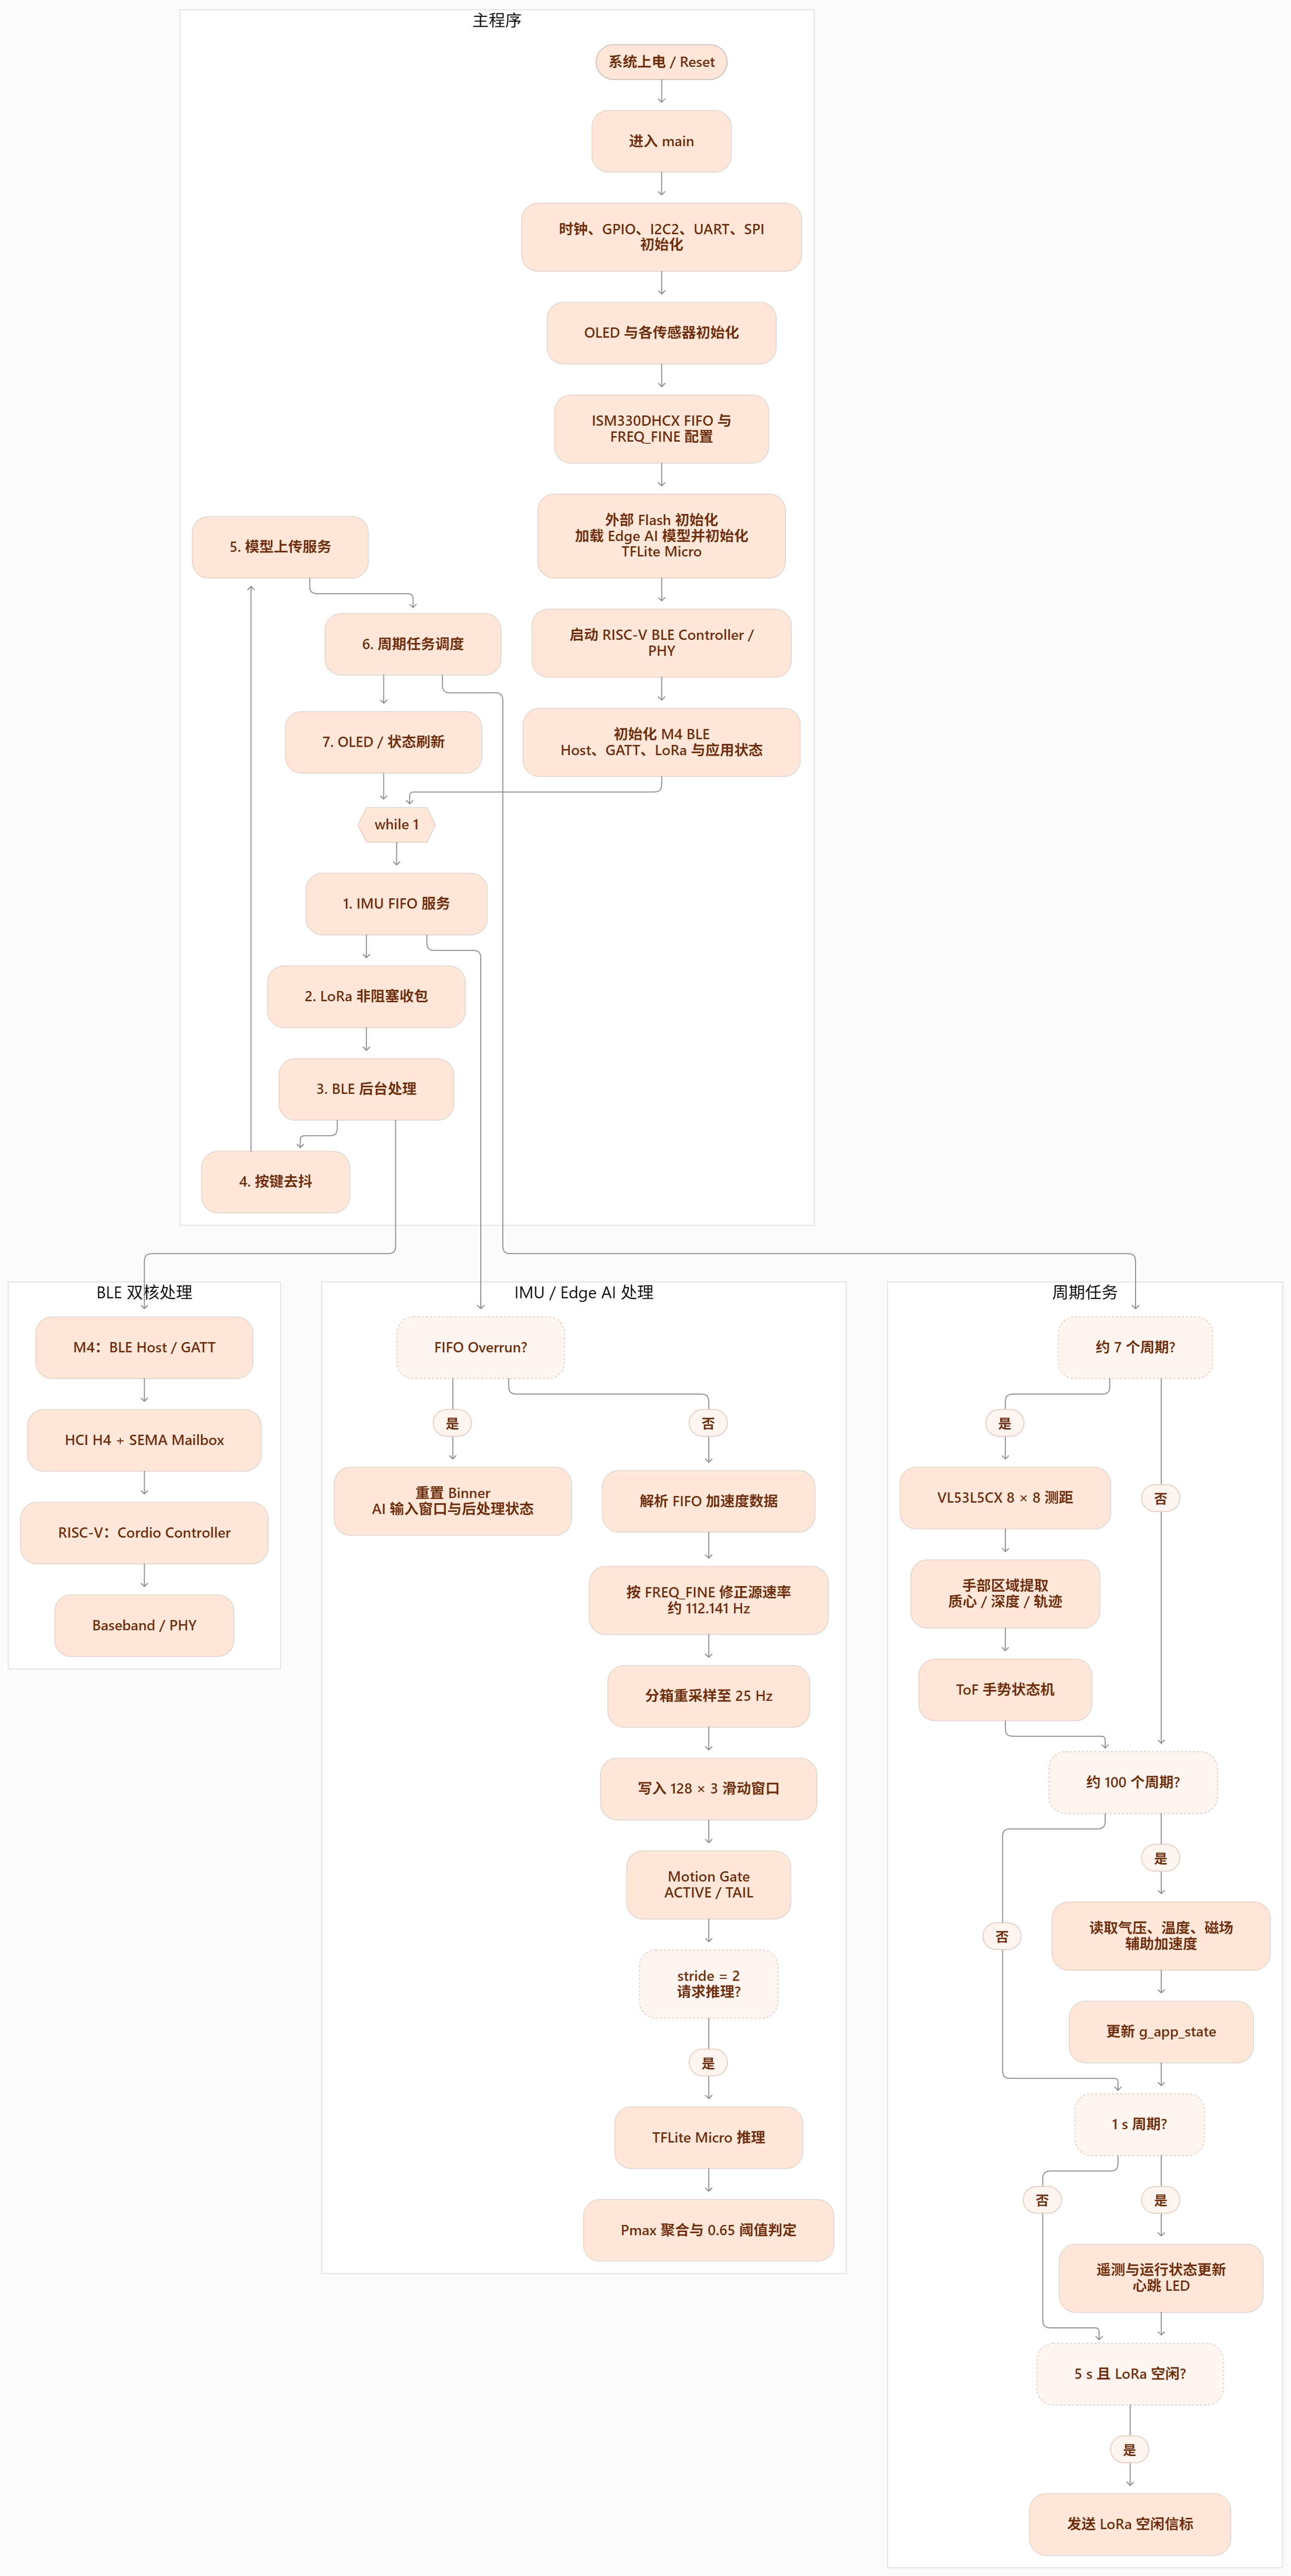
整体流程图:
三、实现过程
3.1 开发环境搭建
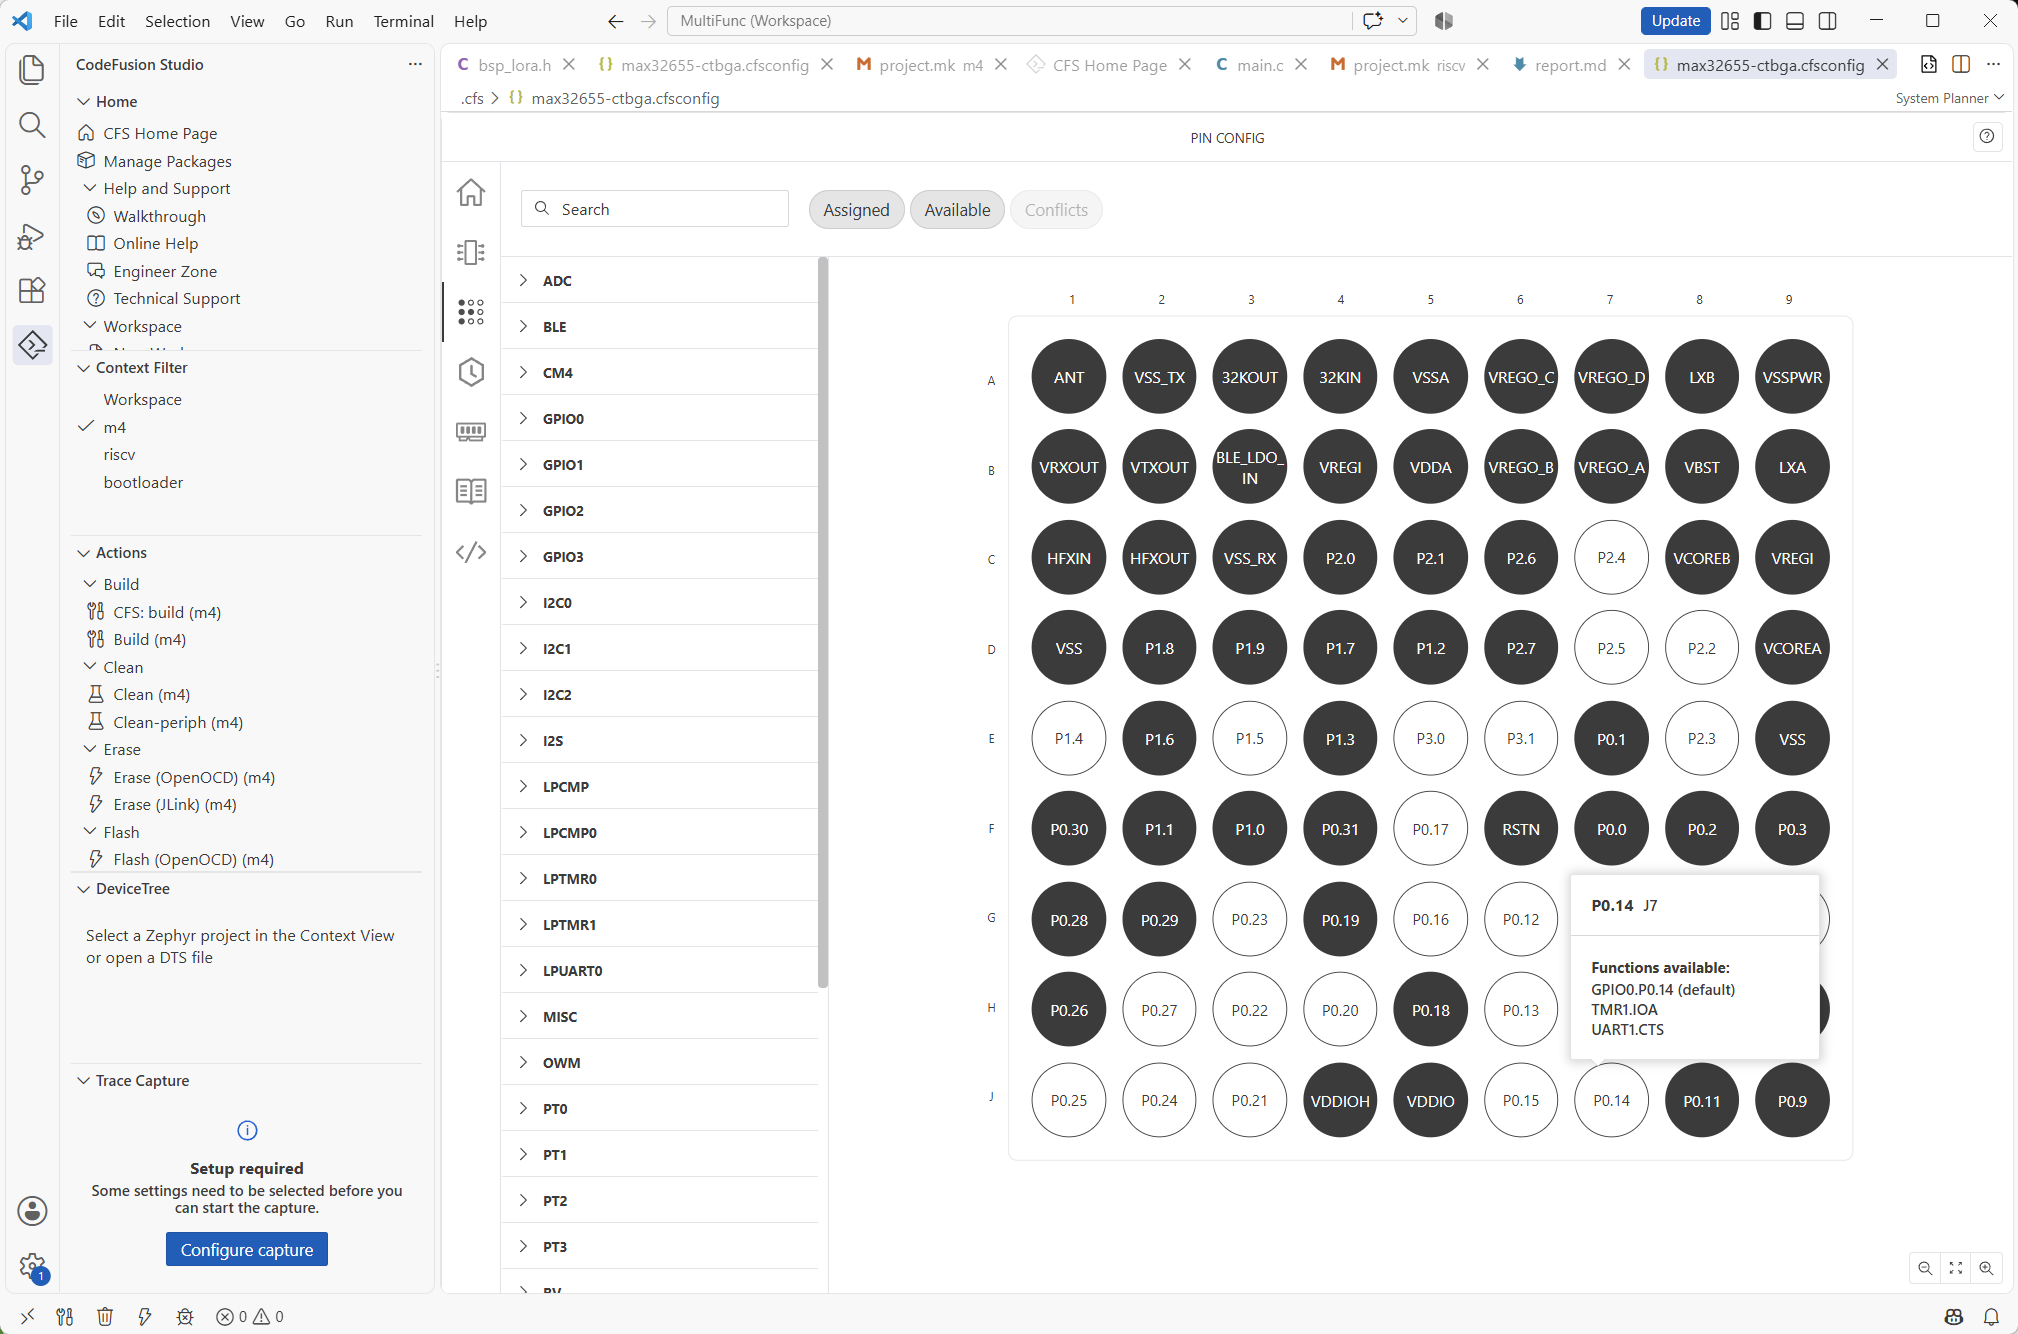
安装 Visual Studio Code 以及 CodeFusion Studio,会同时安装对应的 vscode 插件以及SDK和编译器,可以在 vscode 实现一站式实现引脚分配、编译、固件刷写和调试。
3.2 外设配置与代码生成
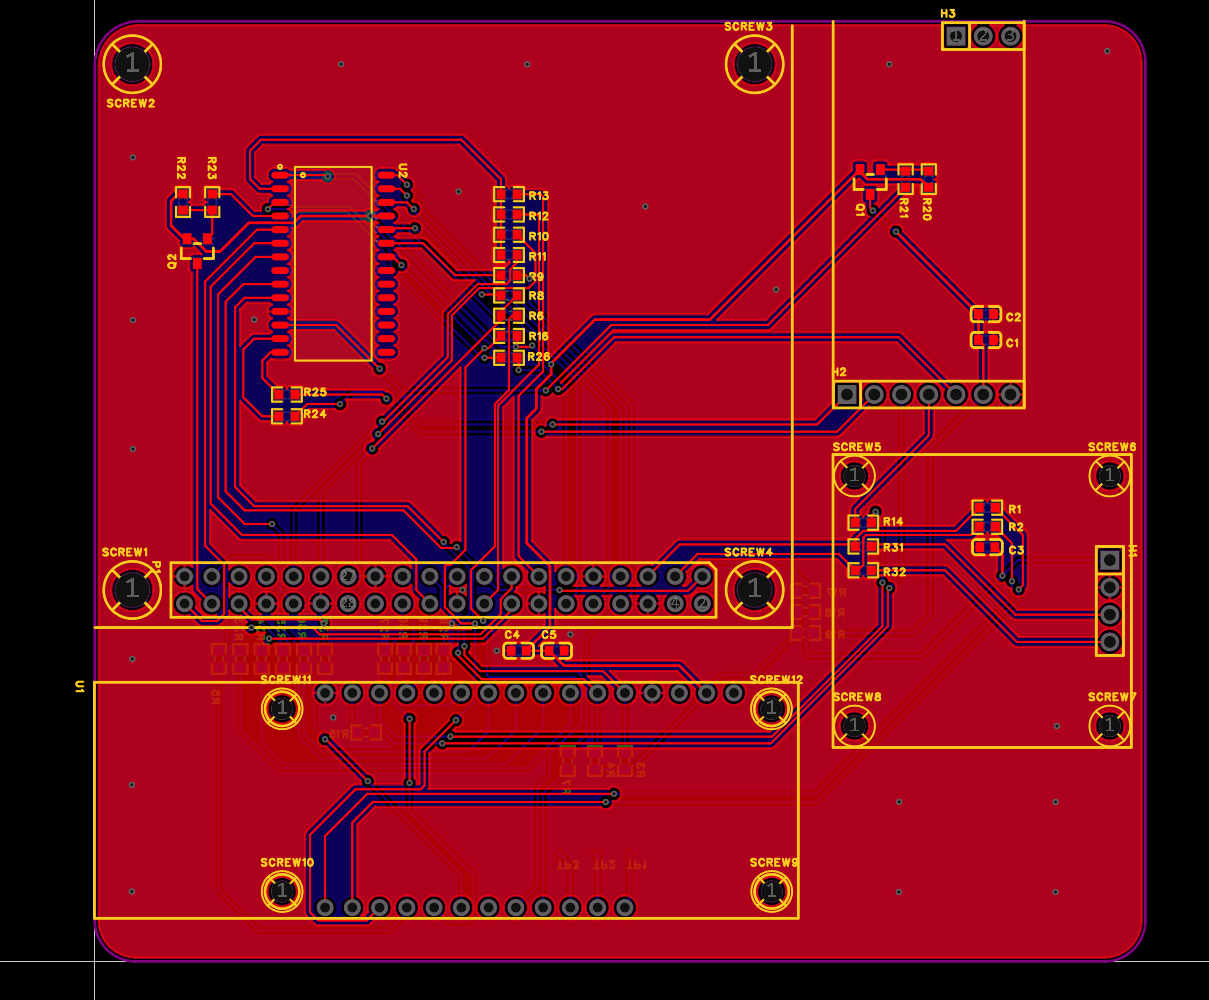
根据 X-STM32MP-MSP01 扩展板、LoRa和OLED显示屏模块设计了底板。
完成总体硬件连接后,根据原理图对 MAX32655 的外设资源和引脚复用进行统一规划。本项目的大部分低速传感器共享 I2C2 总线,LoRa 模块使用独立的低功耗 UART,BLE 由芯片内部 RISC-V 无线子系统完成,另外预留 SPI/QSPI 接口连接外部 Flash,用于模型和 OTA 镜像存储。
主要外设连接如下表所示。
功能 | MAX32655 接口 | 主要引脚/参数 | 用途 |
|---|---|---|---|
主传感器总线 | I2C2 | P0.30=SCL,P0.31=SDA,400 kHz | IMU、ToF、OLED 及其他 I2C 传感器 |
OLED | I2C2 | 地址 0x3C | 本地状态显示 |
VL53L5CX ToF | I2C2 | 地址 0x29 | 8×8 距离阵列 |
ISM330DHCX | I2C2 + GPIO INT | 104 Hz;最终采用 INT2 | 加速度计与陀螺仪采集 |
CH423S | 两线控制接口 | P2.0、P2.1 | GPIO 扩展 |
LoRa | UART3 / LPUART0 | P2.6=RX,P2.7=TX,9600 8N1 | DX-LR01 透明数据通信 |
调试串口 | UART0 | 115200 8N1 | 日志输出与系统调试 |
SPI Flash | SPI/QSPI | W25Q 系列 | 可选用于 Edge AI 模型及 OTA 镜像存储 |
其中,传感器总线统一使用 I2C2 400 kHz。采用共享总线可以显著减少 MCU 引脚占用,同时便于后续增加新的传感器。实际扫描中能够正确识别 OLED 的 0x3C、VL53L5CX 的 0x29 以及其他板载传感器地址,验证了总线连接和上拉配置正常。
3.2.1 I2C 与传感器配置
本项目同时使用了 硬件 I²C 和 GPIO 软件模拟两线总线。两者承担不同外设,主要目的是保证主传感器总线稳定,同时隔离 CH423S 的地址/命令冲突。CH423S 虽然采用 SCL/SDA 两线接口,并在电气时序上兼容 I²C,但其协议并不是典型的“固定 7 位从机地址 + 寄存器地址”结构,而是将首字节直接作为不同功能的命令码使用。不同命令会对应多个类似 I²C 地址的首字节,因此在标准硬件 I²C 控制器中使用时,会表现为占用一段地址空间,并可能与主传感器总线上的标准 I²C 器件产生地址冲突。
因此,本项目将 CH423S 从硬件 I²C2 主传感器总线上独立出来,使用 P2.0 / P2.1 通过 GPIO 软件模拟两线时序。这样既能够严格按照 CH423S 的命令格式控制 START、STOP、ACK 和命令字,又避免其特殊地址编码影响标准 I²C2 总线上的传感器。
总线 | 引脚 | 速率 | 连接器件 | 设计原因 |
|---|---|---|---|---|
硬件 I²C2 | P0.30 / P0.31 | 400 kHz | OLED、ISM330DHCX、IIS2DLPC、IIS2MDC、LPS22HH、STTS22H、VL53L5CX、VD6283、ST25DV 等 | 标准 I²C 外设较多,需要硬件控制器保证效率和稳定性 |
软件模拟两线总线 | P2.0 / P2.1 | 低速控制 | CH423S | 将 CH423S 与主 I²C 总线隔离,避免其命令/地址空间与已有 I²C 设备产生冲突,并便于独立控制时序 |
硬件 I²C2 总线配置为 400 kHz Fast Mode。实际调试中,该总线能够稳定识别存在的设备。
软件初始化顺序采用:
GPIO / Pin Mux
      ↓
I2C2 初始化
      ↓
I2C 地址扫描
      ↓
各传感器 ID 检查
      ↓
寄存器初始化
      ↓
进入周期采样
这样处理的好处是,如果某个传感器未正确连接,可以在系统正式进入业务逻辑前直接定位到 I2C 层,而不必等到上层算法出现异常。
例如 ISM330DHCX 配置为 104 Hz ODR,完成初始化后先通过轮询方式验证数据正确性,再启用硬件中断。在调试过程中发现 INT1 经电平转换器后的电平行为不符合预期(可能是由于需要上电时保持INT1引脚处于低电平,而底板设计时没有发现这一点),而 INT2 可以稳定产生完整的低—高—低中断波形,因此最终软件固定使用 INT2 作为 IMU 数据就绪中断源。这也避免了在后续 BLE、LoRa 等任务加入后持续轮询传感器所带来的 CPU 占用。
3.2.2 LoRa 串口配置
DX-LR01 采用独立 UART 与 MAX32655 通信。根据扩展板连接,UART3 对应 MAX32655 的低功耗 UART 外设,使用:
P2.6  ←  DX-LR01 TXD
P2.7  →  DX-LR01 RXD
串口参数设置为:
9600 baud
8 data bits
No parity
1 stop bit
LoRa 模块采用透明传输方式,因此对于上层程序而言,其接口与普通串口数据流基本一致。M4 只需要完成业务数据封装,再通过 UART3 发送,模块负责后续的 LoRa 调制和射频发送。
这种设计也使 LoRa 与 BLE 软件路径保持相对独立:BLE 数据通过 Mailbox 进入 RISC-V 无线子系统,而 LoRa 数据直接由 M4 通过 UART3 发送,两条无线链路不会竞争同一通信外设。
3.2.3 GPIO 与电源域配置
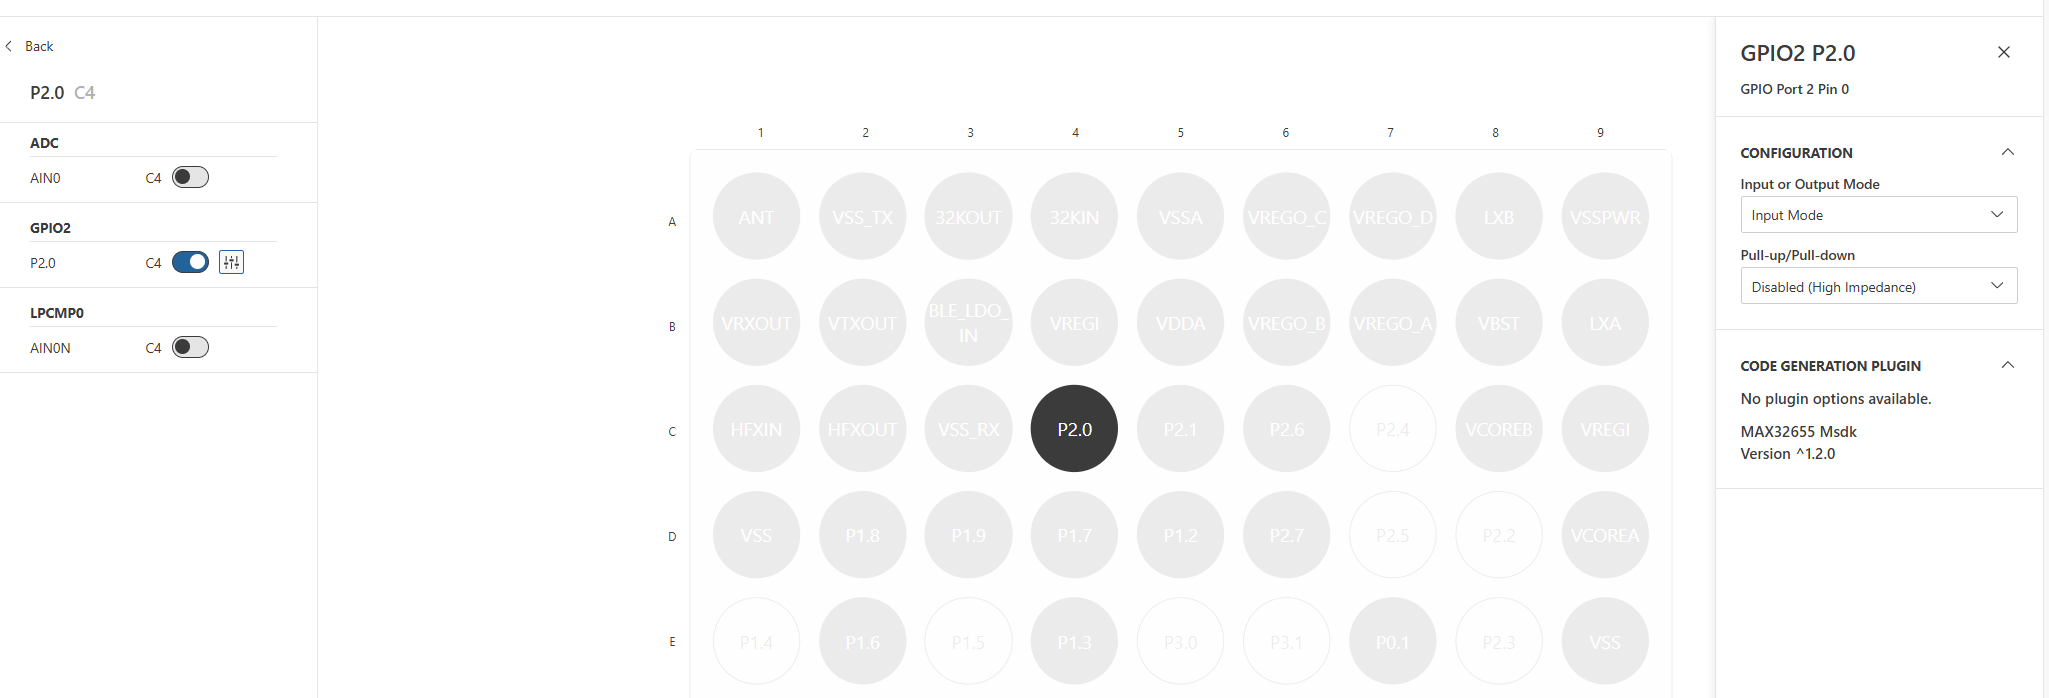
除了普通的引脚复用外,本项目还需要特别关注 MAX32655 的 VDDIO / VDDIOH 电源域配置,默认外设都工作在 3.3V 所以都需要设置为 VDDIOH。
在配置 P2.0( CH423S )的电源域时发现没有相关的电源域配置选项,手动在文件中配置为 VDDIOH 后,在重新生成配置后被恢复为默认 VDDIO,导致实际电平与扩展板接口设计不一致(实际发现不影响使用)。
3.2.4 BLE 定时资源配置
MAX32655 的 BLE Cordio 协议栈不仅依赖射频和 Mailbox,还需要独立的硬件定时资源完成 Link Layer 调度、无线事件定时及低功耗唤醒。在本项目的双核架构中,BLE Controller 运行于 RISC-V 核,因此相关定时资源也划归 RISC-V 侧管理。
其中,TMR0 用于 BLE Controller / Baseband 的高精度调度,负责广播、连接事件及无线收发相关的时序控制;TMR1 用于低功耗 sleep timer,在无线任务空闲期间提供休眠与下一次事件唤醒的时间基准。
WUT0 则由 Cordio PAL 的 RTC/系统定时功能使用,作为低功耗时间基准及唤醒相关定时资源。
3.2.5 CFS 配置与代码生成
工程首先在 CodeFusion Studio 的配置工具中完成 MCU 时钟、GPIO、Pin Mux 、SRAM、FLASH 以及基础外设实例的设置,再生成相应的初始化代码。
本项目 M4 主核工作频率配置为 100 MHz,随后依次配置 I2C2、UART、GPIO 中断以及 SPI 等外设。生成代码完成后,再在用户代码中加入具体设备驱动和应用逻辑。
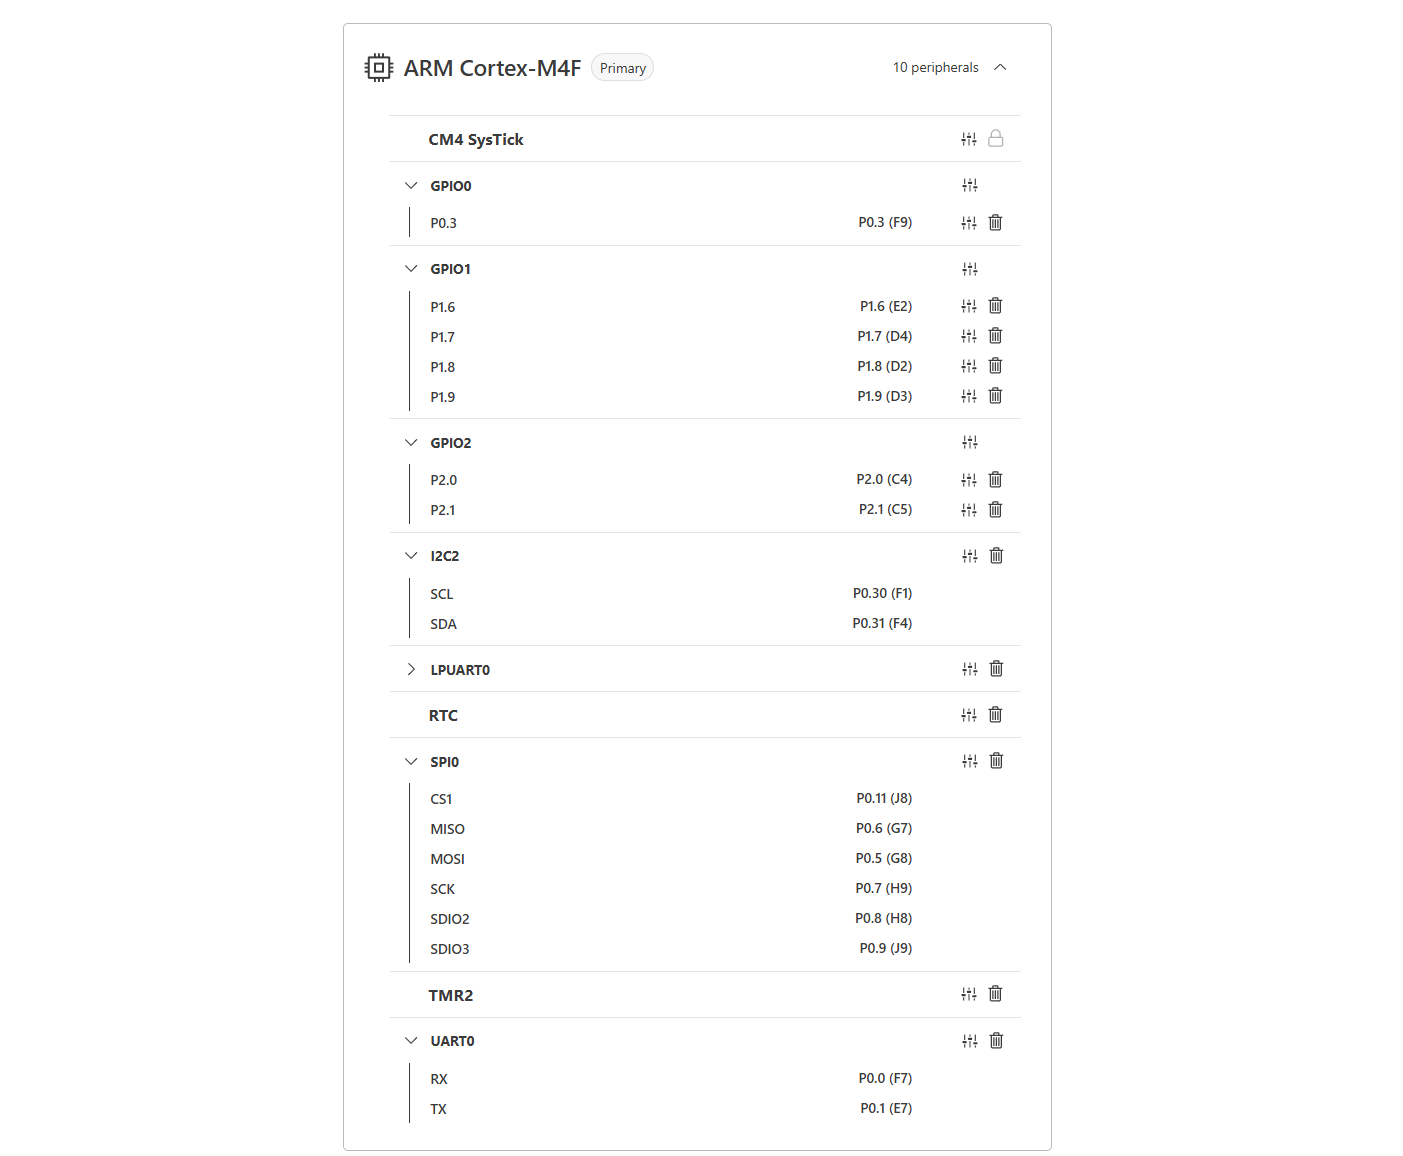
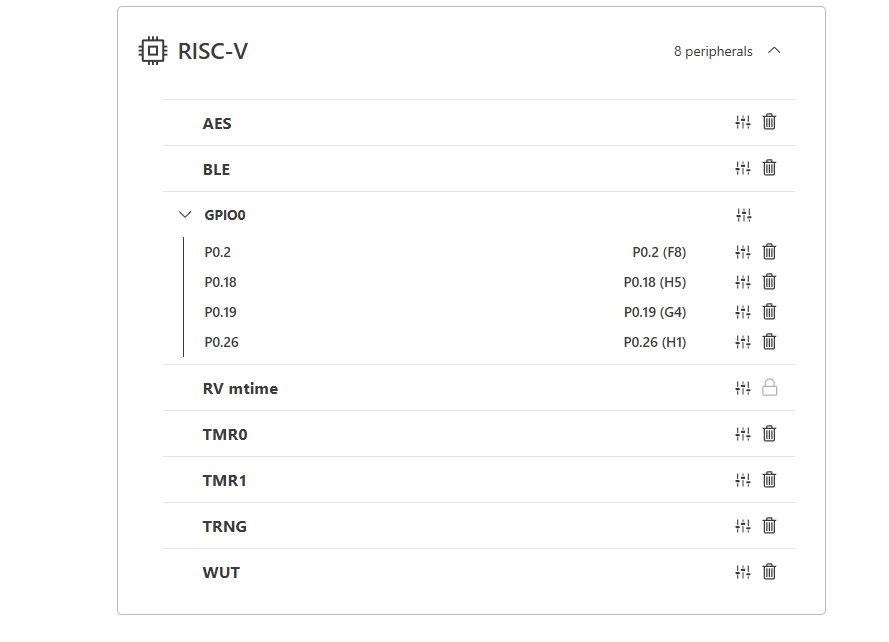
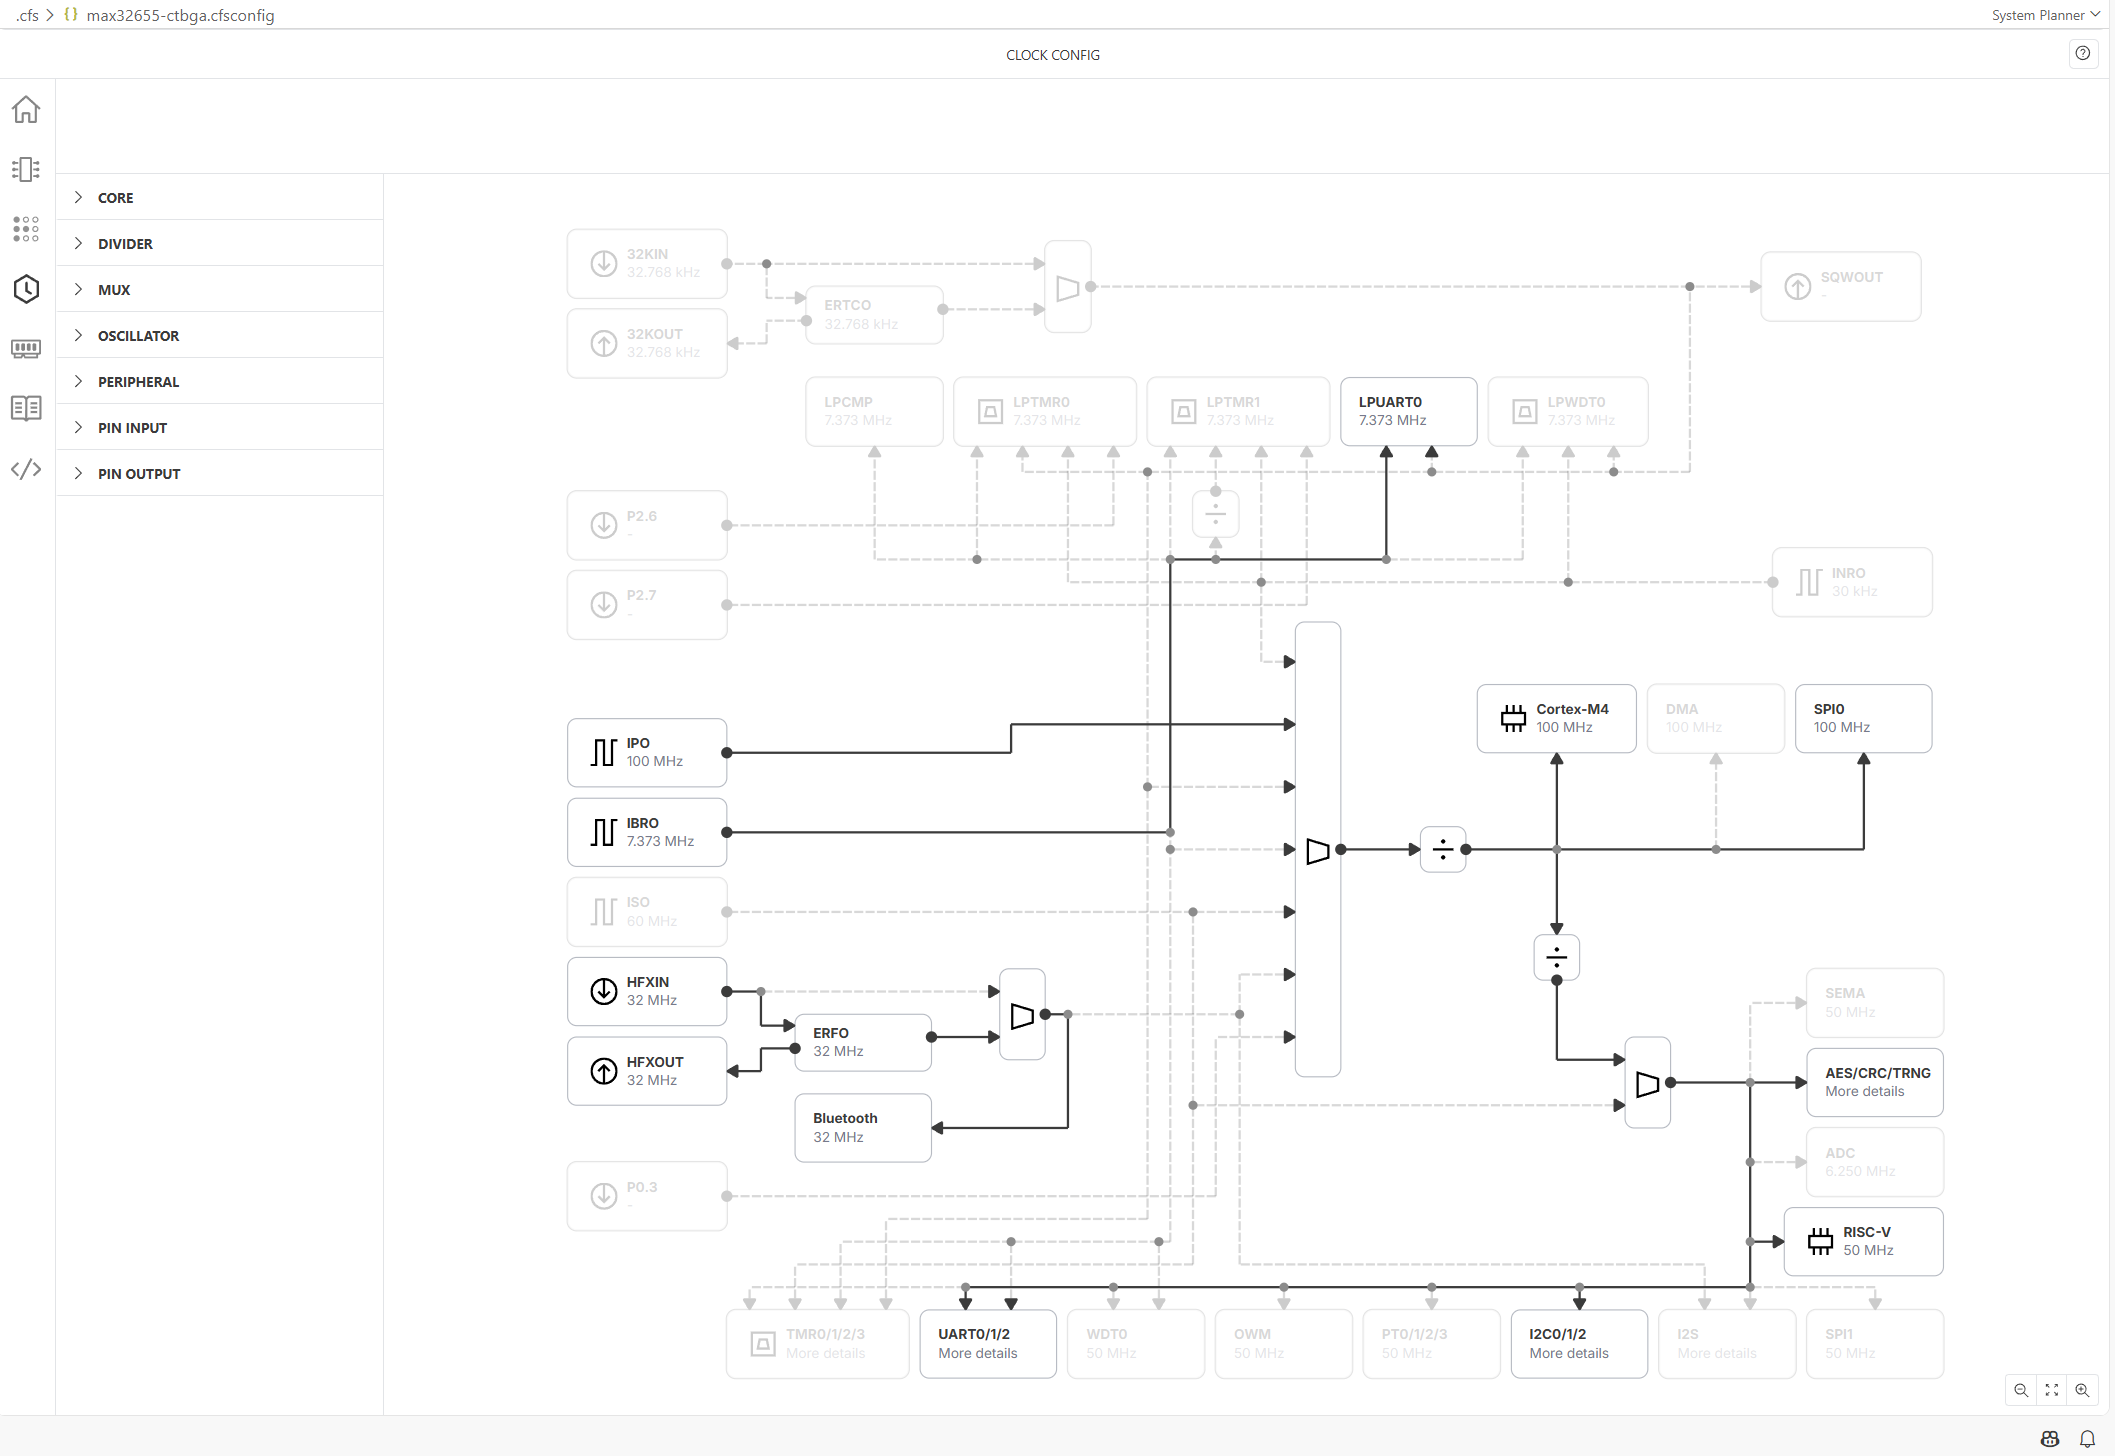
时钟配置
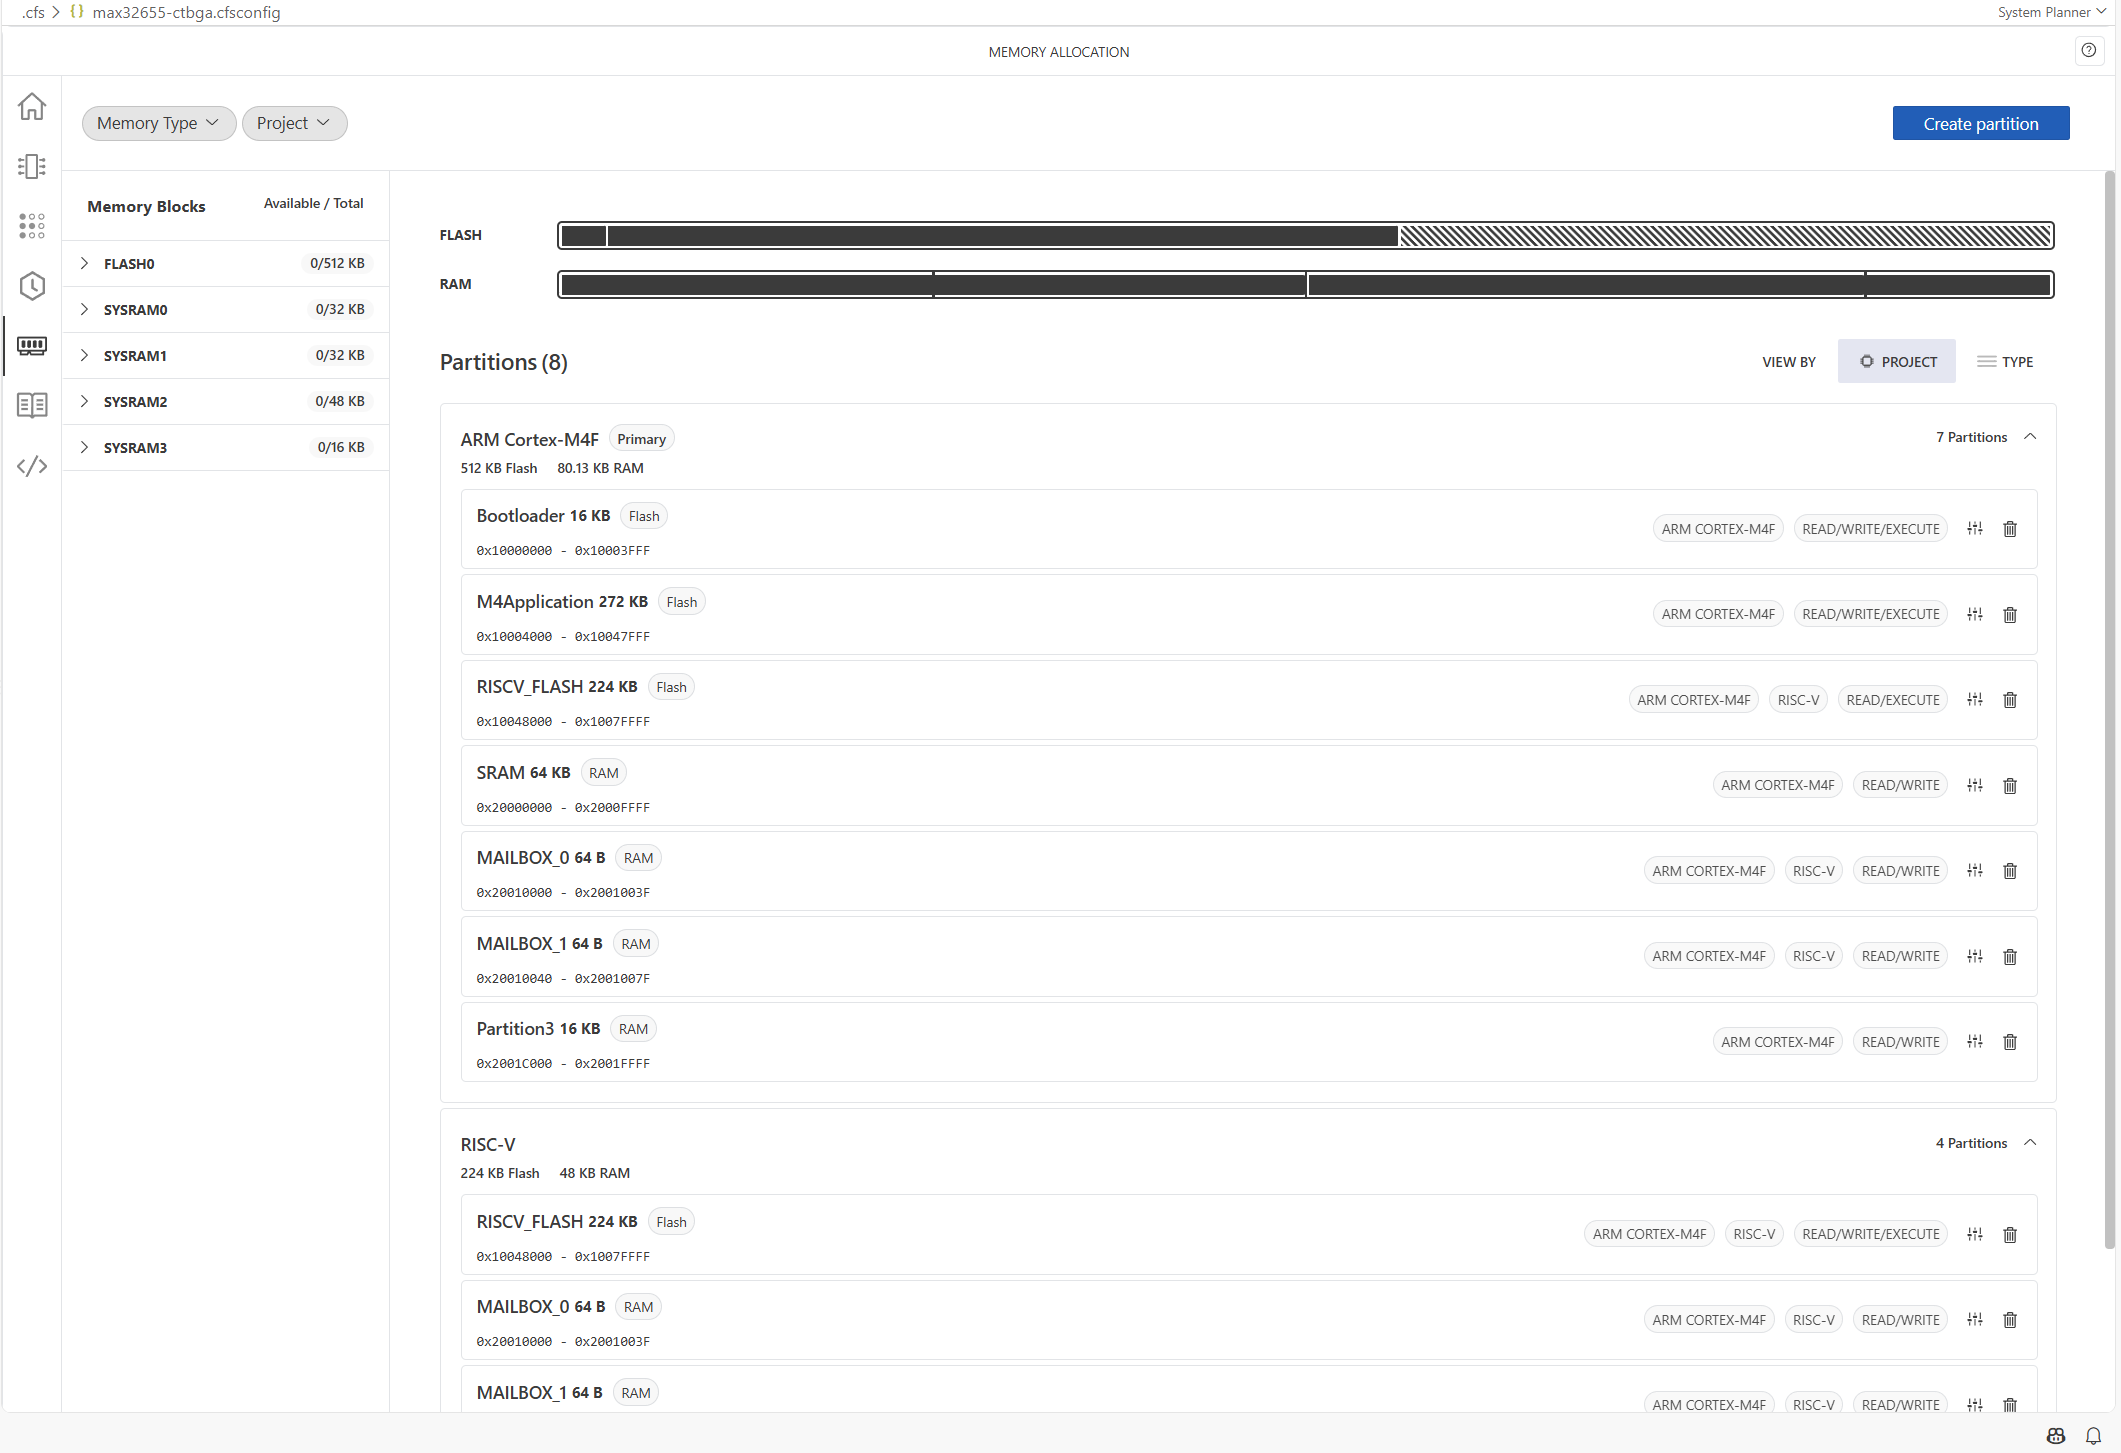
RAM FLASH 资源分配
3.3 主要代码实现
系统软件运行于 MAX32655 Cortex-M4,负责多传感器采集、ToF 手势识别、Edge AI 推理以及 BLE/LoRa 通信。考虑到任务数量固定、单次执行时间较短,系统采用协作式主循环完成多速率任务调度,并利用硬件 FIFO 和状态机保证关键数据链路的连续性。
3.3.1 多传感器采集与任务调度
主循环以约 10 ms 为逻辑调度单位。IMU FIFO、BLE 等高频任务持续执行,VL53L5CX 约 15 Hz 更新,气压、温度、磁场和辅助加速度传感器约 1 Hz 更新。
/* IMU FIFO service */
if (imu_fifo_enabled()) {
    (void)imu_fifo_service();

    if (imu_fifo_take_overrun_event()) {
        edge_ai_runtime_reset_stream();
        edge_ai_postprocess_reset();
    }
}

/* VL53L5CX: approximately 15 Hz */
if (slice_count % 7 == 0) {
    int tof_ret =
        bsp_vl53l5cx_poll_raw(&g_app_state.tof_raw);

    if (tof_ret == 1) {
        tof_gesture_process_frame(
            &g_app_state.tof_raw, NULL);
    }
}

/* Low-rate sensors: approximately 1 Hz */
if (slice_count >= 100) {
    slice_count = 0;

    lps22hh_read_data(&press_hpa, &temp_lps);
    stts22h_read_temp(&temp_stts);
    iis2mdc_read_data(&bx, &by, &bz);
    iis2dlpc_read_data(&a2x, &a2y, &a2z);
}
ISM330DHCX 的普通轮询数据用于 OLED 显示和遥测,而 Edge AI 单独使用硬件 FIFO 作为输入源,使采样时刻由传感器自身 ODR 决定,不依赖主循环执行周期。
程序根据 INTERNAL_FREQ_FINE 修正 IMU 源采样率,当前样机对应的计算值约为 112.141 Hz,随后通过分箱转换为长期平均 25 Hz 的模型输入。若 FIFO 发生 Overrun,当前分箱、模型窗口和后处理状态会同时复位,避免将不连续数据拼接到同一推理窗口中。
多个传感器和 OLED 共用 I2C2 总线,因此系统还实现了带超时的故障恢复机制,使单个外设异常不会长期阻塞整个主循环。
3.3.2 ToF 手势识别与事件处理
VL53L5CX 工作于 8×8 多区域测距模式。程序首先根据目标状态和距离提取有效手部区域,并通过连通域过滤孤立噪声,只保留最大的有效区域。
随后根据目标距离和有效性计算二维加权质心,同时提取手部中值深度,并保存最近 10 帧轨迹,为动态手势识别提供空间和时间信息。
float prox_w =
    weights[i] *
    (HAND_MAX_MM - raw->distance_mm[i] + 100);

sum_w  += prox_w;
sum_wx += col_coord * prox_w;
sum_wy += row_coord * prox_w;

if (sum_w > 0.001f) {
    feat->centroid_x = sum_wx / sum_w;
    feat->centroid_y = sum_wy / sum_w;
}
系统根据连续轨迹中的水平位移、垂直位移以及深度变化识别:
LEFT、RIGHT、UP、DOWN、APPROACH
识别过程采用 IDLE → TRACKING → CONFIRMED → COOLDOWN → WAIT_RELEASE 状态机。一次手势确认后,必须经过冷却并检测到手部离开,才重新接受下一次动作,从而避免持续悬停或单次动作产生重复触发。
手势确认后生成统一事件:
if (detected != GESTURE_NONE && score >= 50) {
    s_fsm_state = TOF_FSM_CONFIRMED;

    event_item_t evt;
    memset(&evt, 0, sizeof(evt));

    evt.seq = app_event_alloc_seq();
    evt.src = EVT_SRC_TOF;
    evt.gesture = detected;
    evt.score = score;
    evt.dist_mm =
        (feat->median_depth_mm > 0)
            ? (uint16_t)feat->median_depth_mm
            : 0;

    app_event_post(&evt);
    app_event_history_add(&evt);

    s_fsm_state = TOF_FSM_COOLDOWN;
    s_cooldown_timer = COOLDOWN_FRAME_COUNT;
}
事件模块再根据系统状态完成 BLE Notify 和 LoRa 队列发送,使手势识别逻辑与具体通信协议保持独立。
3.3.3 Edge AI 推理实现
系统在 Cortex-M4 上运行开源的 TensorFlow Lite Micro Magic Wand 模型 ,通过 ISM330DHCX 三轴加速度识别 wing、ring、slope 和 negative 四类动作。
模型输入尺寸为 [1,128,3,1]。FIFO 数据经重采样后以 25 Hz 输入,因此一个完整窗口覆盖约 5.12 s。
模型输入采用 128×3 环形缓冲区持续滑动。上游始终保持以 g 为单位,在进入 Runtime 后统一完成模型坐标转换以及 g→mg 单位转换,并在需要推理时整理为连续输入。
size_t write_sample =
    (s_sample_head + s_sample_count) %
    AI_MAGICWAND_SAMPLES;

if (s_sample_count == AI_MAGICWAND_SAMPLES) {
    write_sample = s_sample_head;
    s_sample_head =
        (s_sample_head + 1u) %
        AI_MAGICWAND_SAMPLES;
} else {
    ++s_sample_count;
}

const size_t index =
    write_sample * AI_MAGICWAND_AXES;

s_samples[index]     = model_x * 1000.0f;
s_samples[index + 1] = model_y * 1000.0f;
s_samples[index + 2] = model_z * 1000.0f;

if (inference_requested &&
    s_sample_count == AI_MAGICWAND_SAMPLES) {
    make_window_contiguous();

    ai_magicwand_infer(
        s_samples,
        AI_MAGICWAND_INPUT_FLOATS,
        &result);
}
模型输入和最终输出均为 FLOAT32,而模型内部首先执行 Quantize,随后使用 INT8 Conv2D、MaxPool、FullyConnected 和 Softmax,最后再 Dequantize 为四类 FLOAT32 概率,因此应用层无需自行完成 INT8 量化。
为减少无效计算,窗口填满后也不会持续进行推理。动作检测模块先将输入划分为 ACTIVE 和 TAIL 阶段,仅在这些阶段按照 stride=2 请求模型运行。
一次完整动作期间分别记录 wing、ring 和 slope 的最大概率,动作结束后选择其中最高类别;当最大概率达到 0.65 时输出识别结果,否则判定为未识别手势。
当前 TFLite 模型大小约 10 KB。受 MCU 内部 Flash 空间限制,模型独立存储于外部 W25Q128JV Flash,并在运行时加载;Tensor Arena 固定为 8 KB,模型解释器及相关缓冲区均采用静态内存,从而避免运行过程中产生堆碎片。
整个 Edge AI 数据链路可以概括为:
IMU FIFO → 112.141 Hz → 25 Hz → 128×3 滑动窗口 → TFLite Micro → ACTIVE/TAIL 后处理 → Wing/Ring/Slope
通过将采样、模型运行和事件判定分别放在 FIFO、Runtime 与后处理模块中,Edge AI 输入时基不依赖主循环,同时保持了较低的资源占用和清晰的模块边界。
四 、测试结果
4.1 OLED 屏幕显示和界面切换
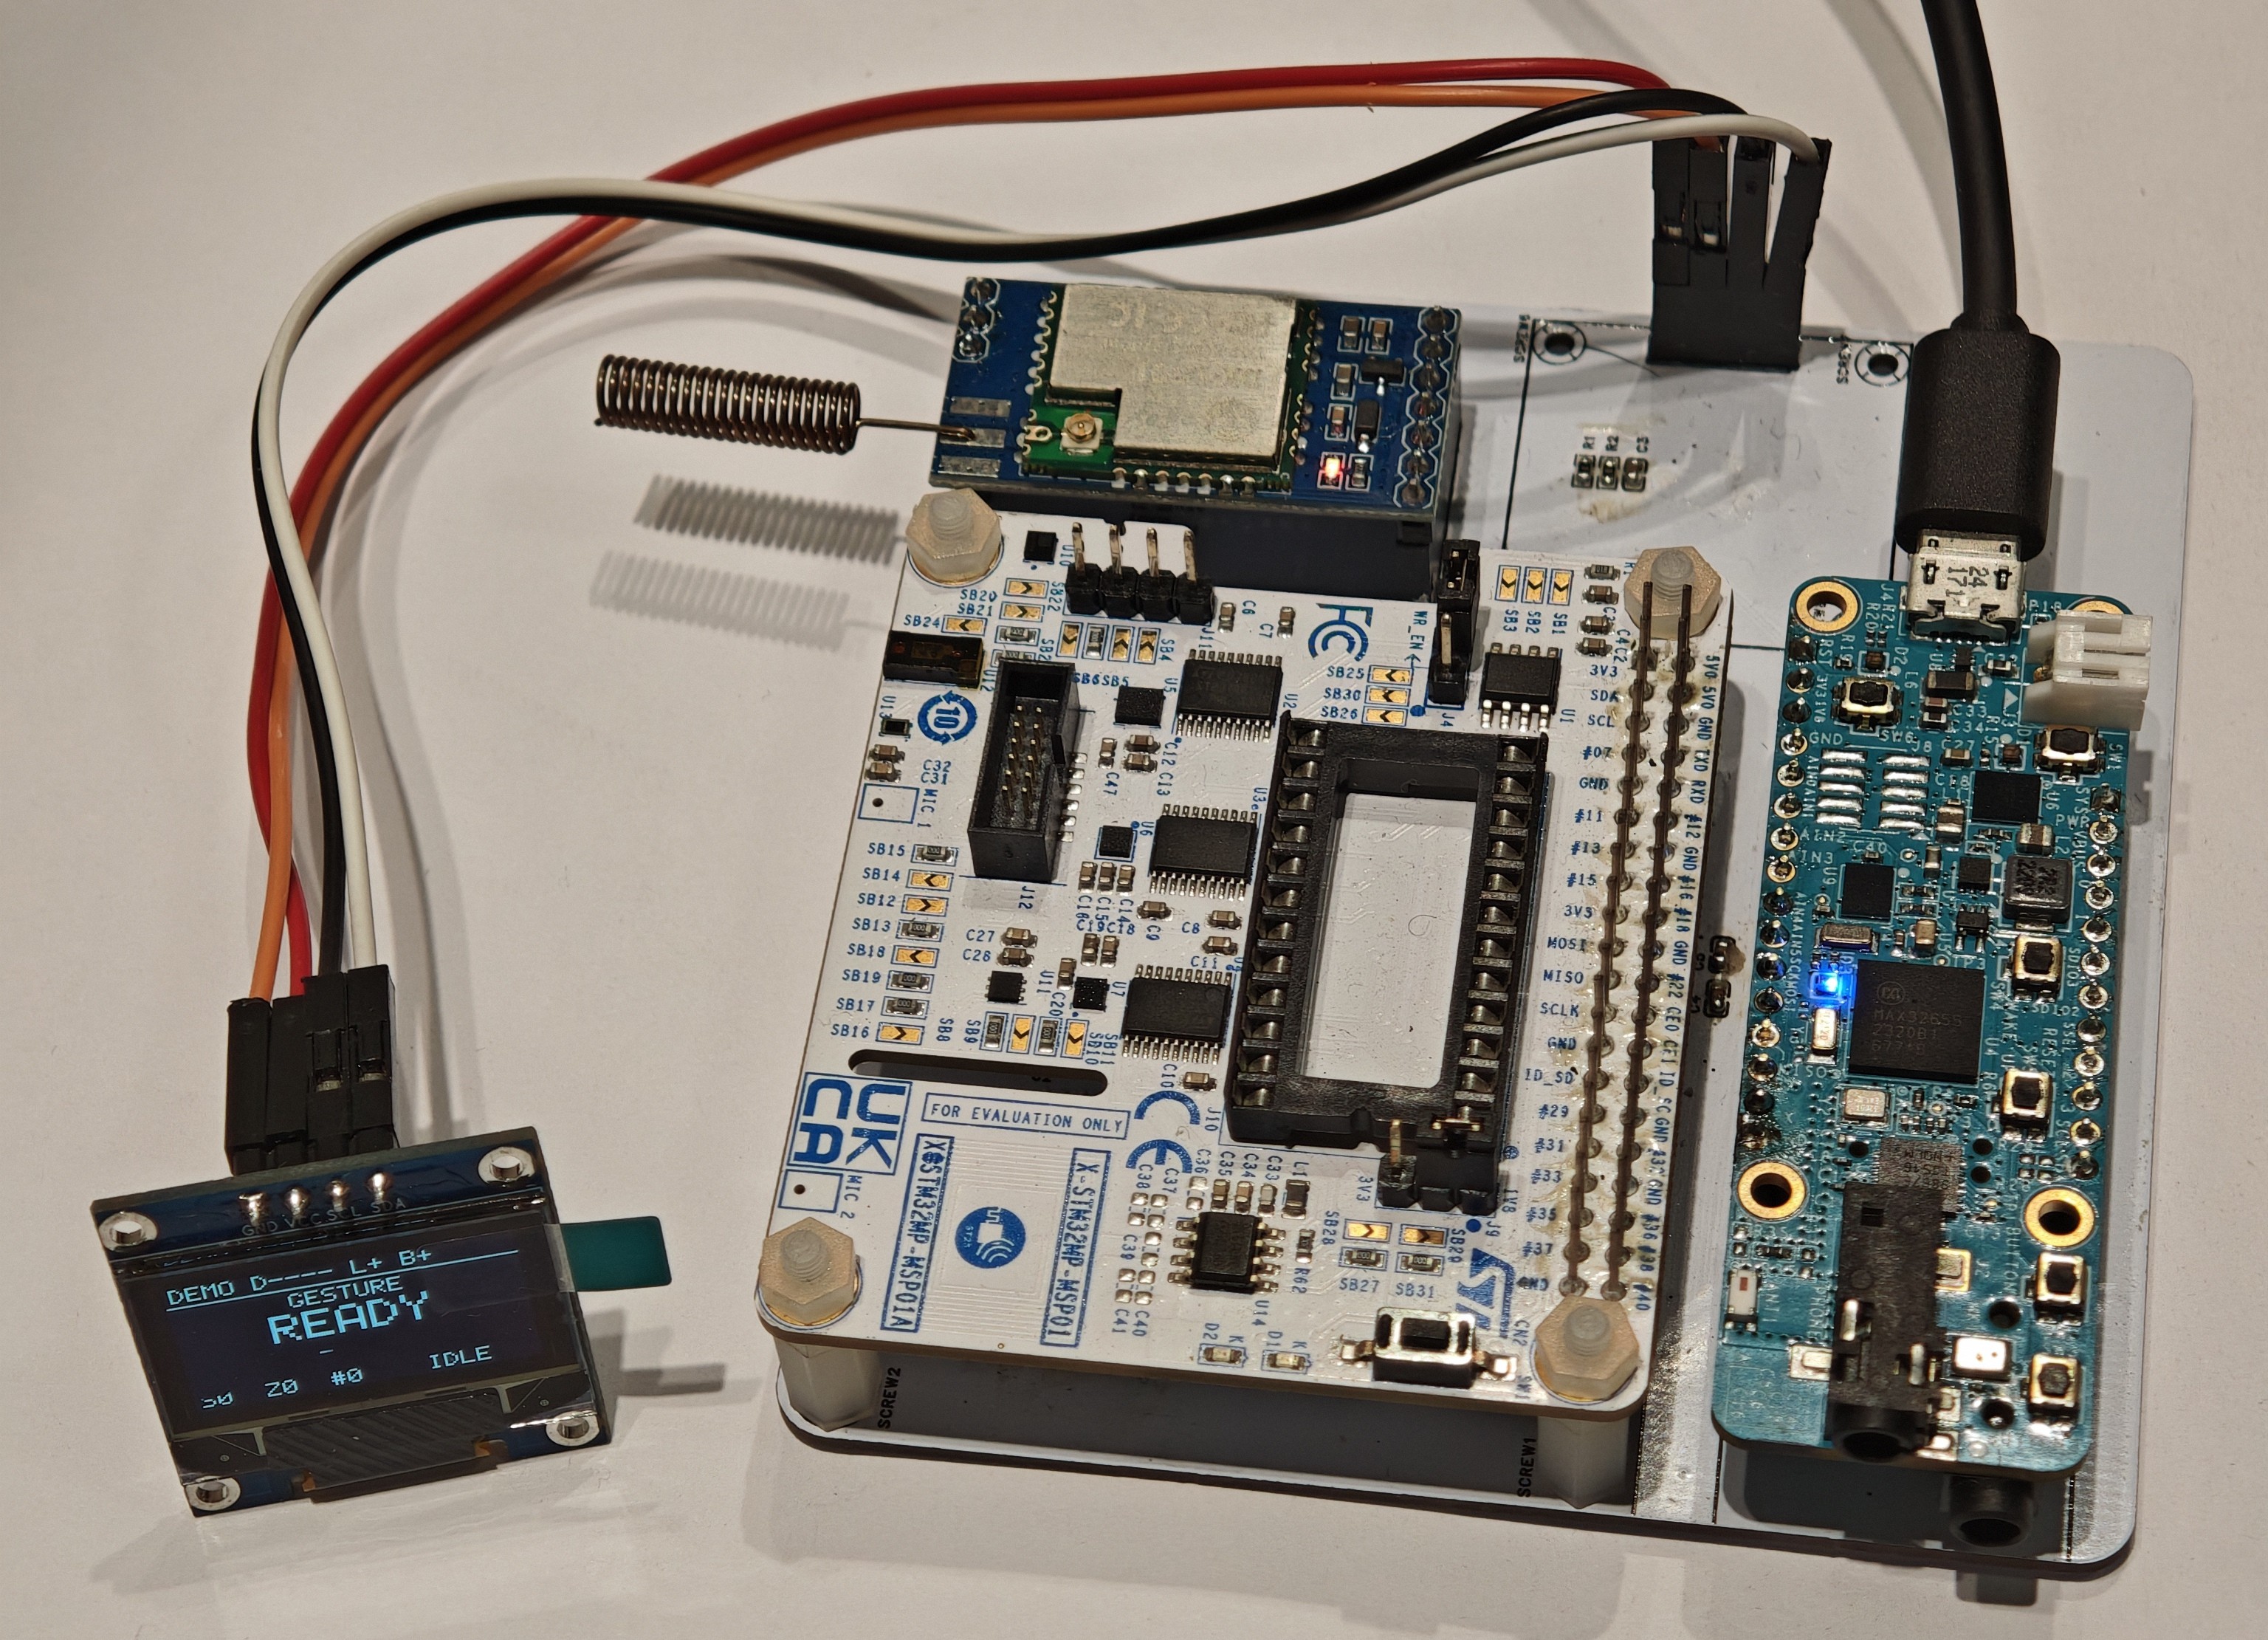
识别结果页面
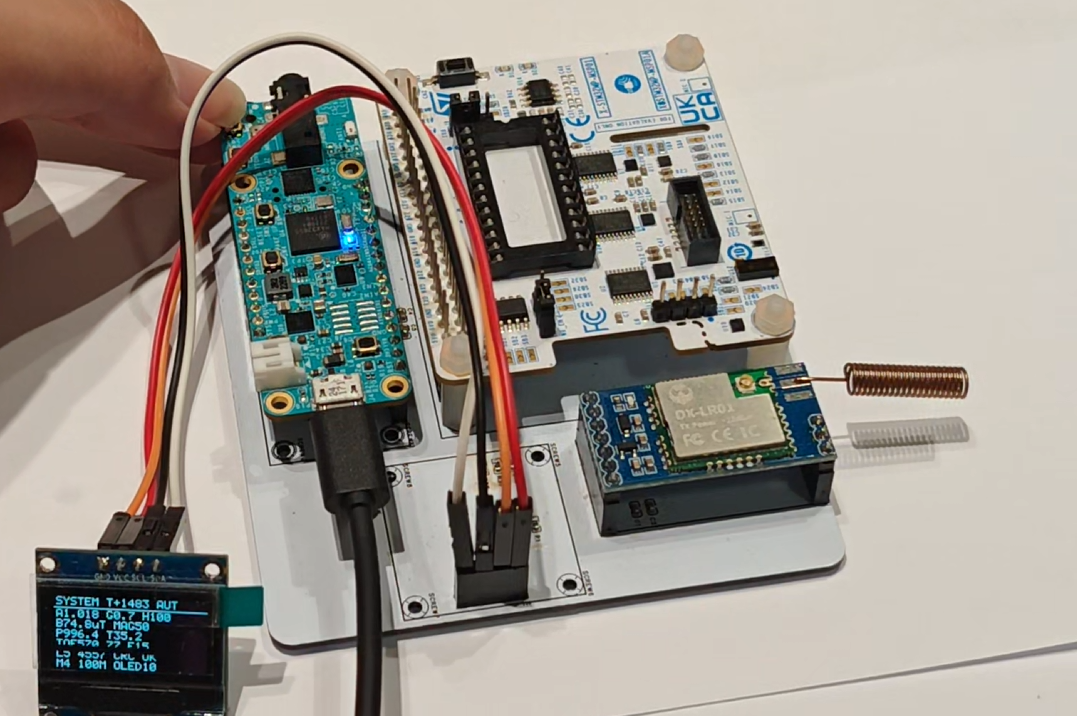
传感器数据
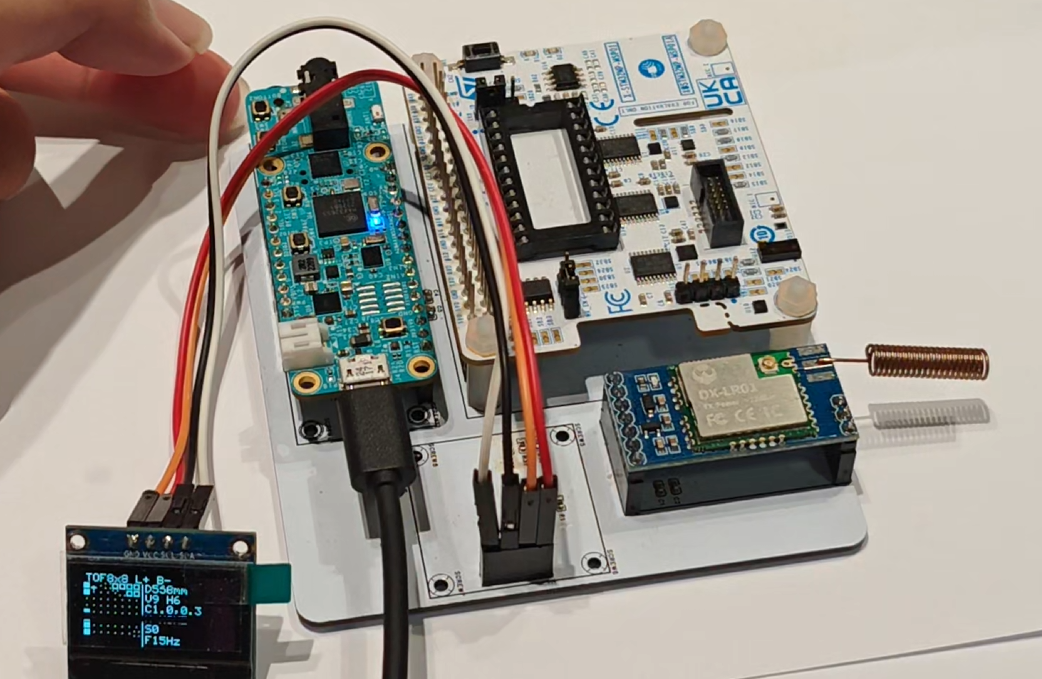
ToF 传感器数据
OLED 屏幕正常显示,并且定时轮换显示界面,包括手势识别结果和传感器数据。单击按键切换到下一个界面,双击锁定显示界面。
4.2 ToF 手势识别
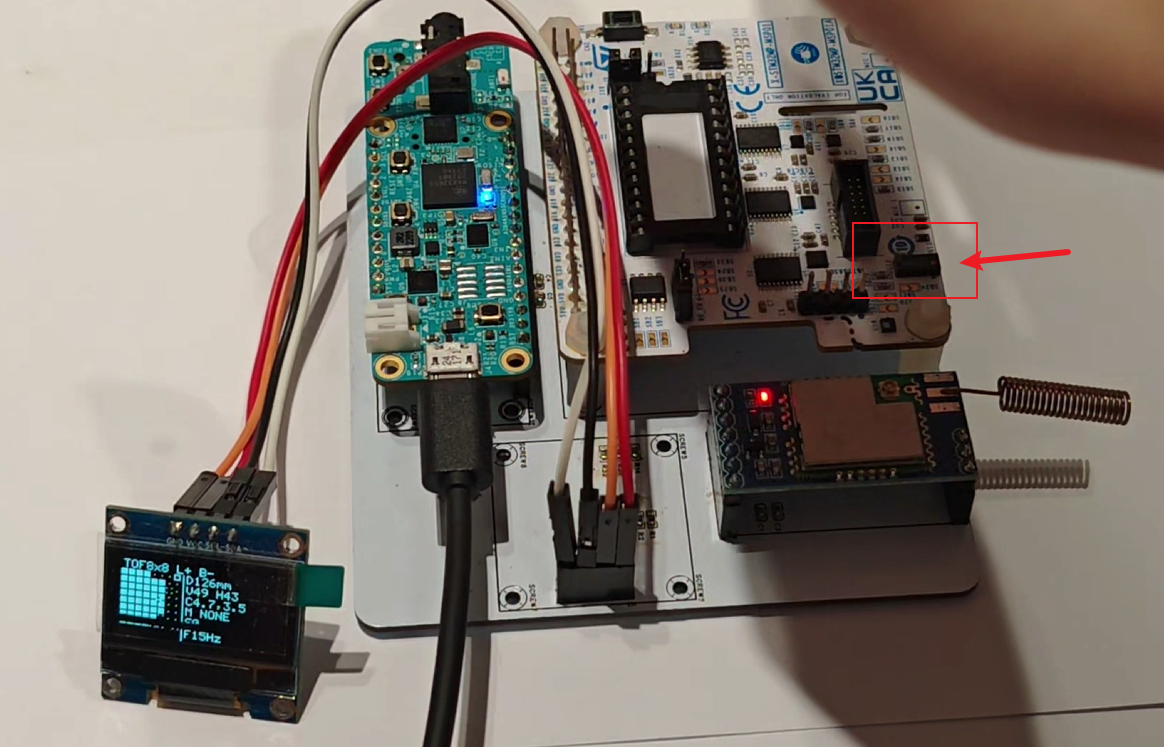
其中 ToF 传感器的 8×8 多区域测距数据用于手势检测,向四个方向滑动手掌,可以看到系统识别到对应方向的滑动手势;屏幕会实时显示识别到的方向,每个区域用不同的图案代表距离的远近。
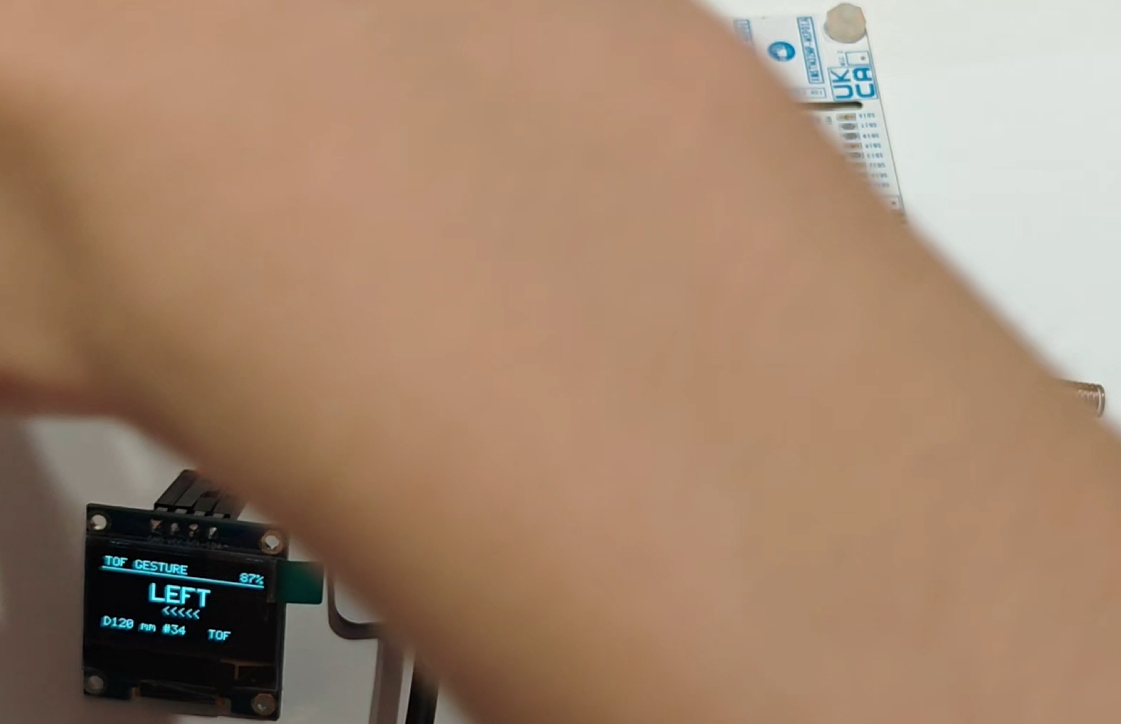
正确识别向左挥动。
4.3 双无线数据推送
这里演示了 ToF 手势识别结果的双无线推送。计算得出的结果同时通过蓝牙 GTAA Notify 和 LoRa 链路向远端发送。
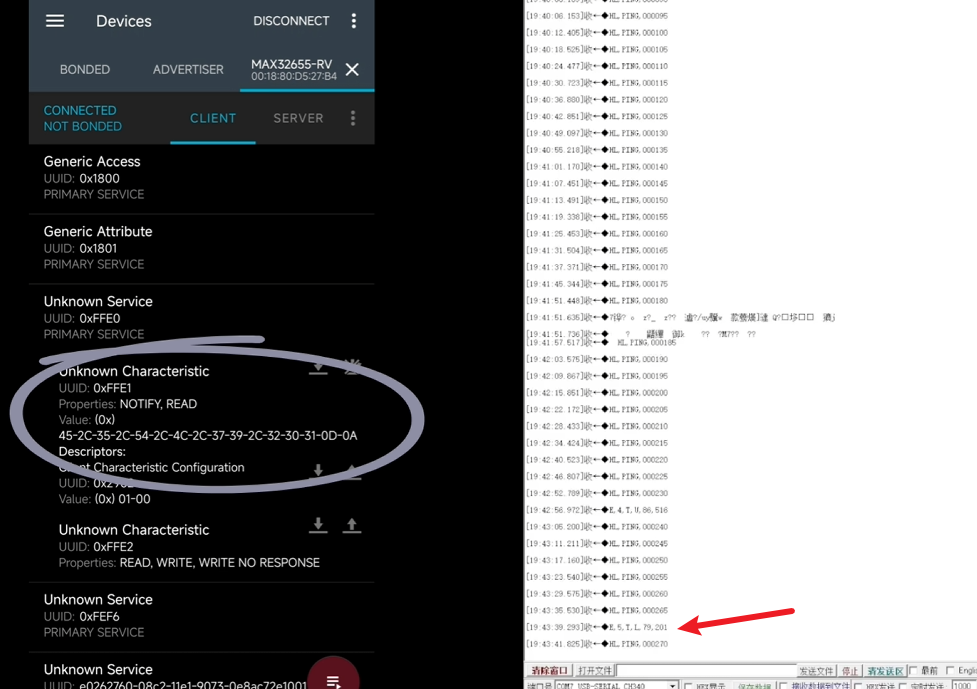
识别出手势后,结果被推送到了远端。蓝牙端用手机通过 nRF connect 能够正常连接并订阅获取测试数据;LoRa 使用另一个模块通过串口获取。生成的 ASCII 报文依次为 E,事件序号、事件源(ToF)、手势方向代码、质量评分以及探测深度/距离。
4.4 边缘 AI 手势识别
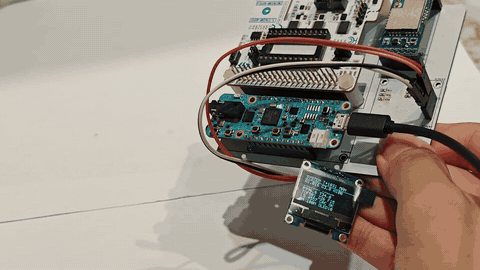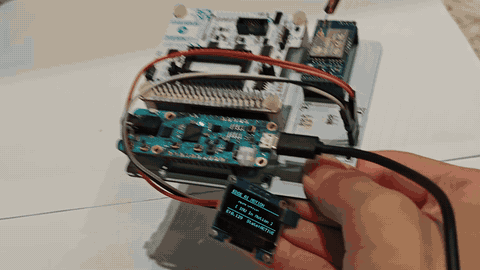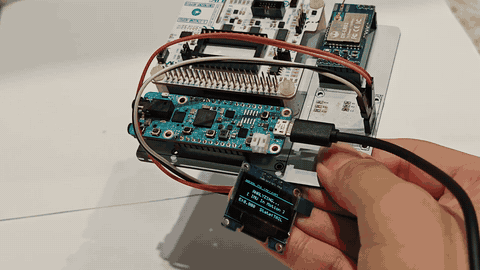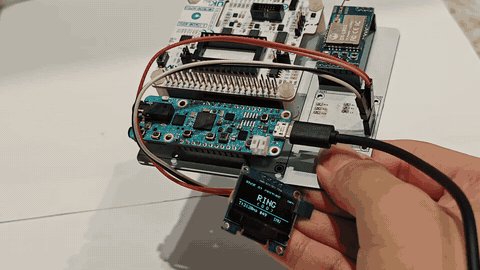
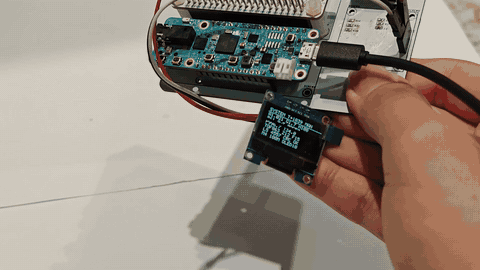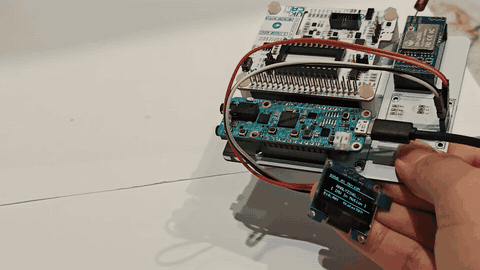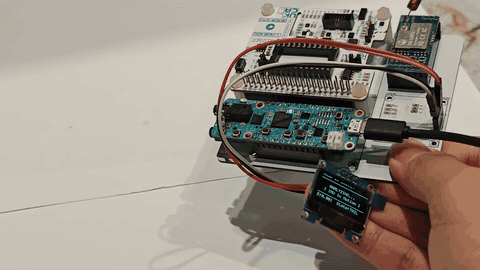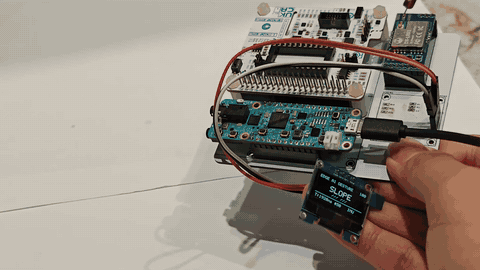
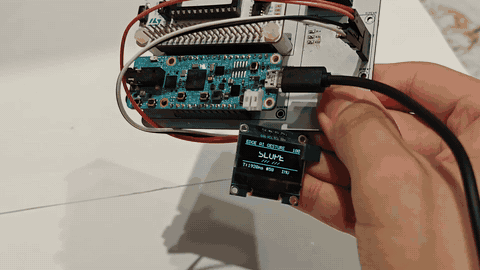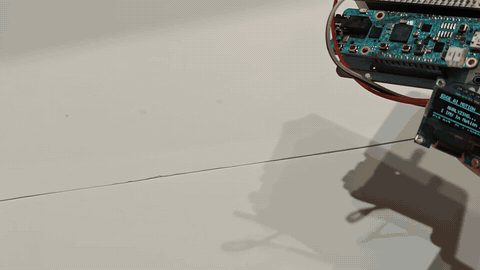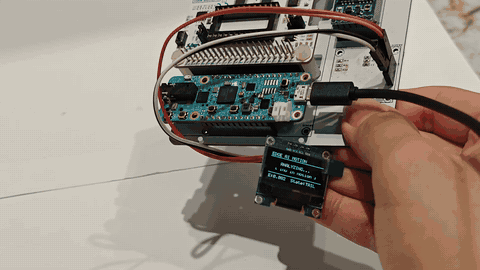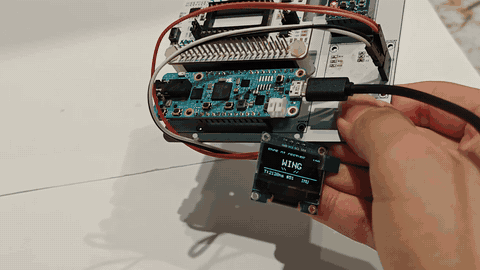
使用模型检测如图所示的手势挥动开发板。通过拓展板的 IMU 采集设备运动数据,并在端侧运行模型进行动作识别。如图所示,模型主要识别三个动作:Ring、Slope 和 Wing。
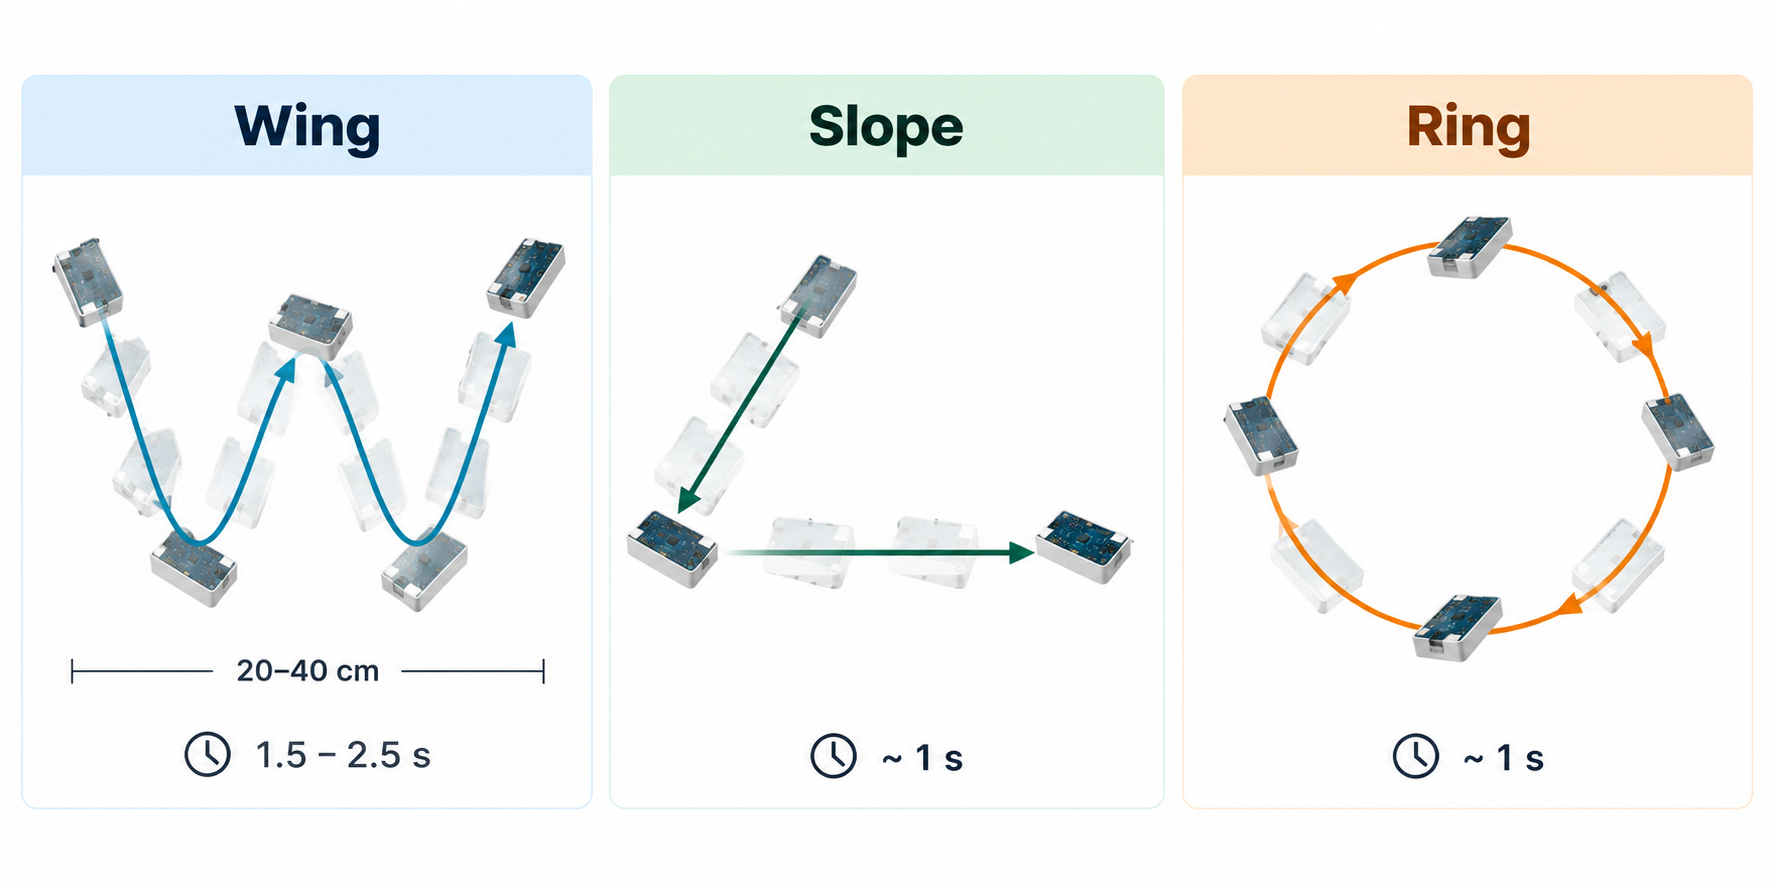
依次展示 ring、slope和wing 手势
4.5 蓝牙 OTA 固件传输与完整性校验功能
这里使用一个 4 KB 的伪固件来演示电脑端传输固件发生 CRC 校验错误的情况。脚本运行后,电脑端先通过蓝牙连接设备并建立 OTA 传输通道,将测试固件分块发送到 spi Flash 的 OTA 暂存区域。该演示在发送之前在 OTA Header 中故意写入错误的 CRC 值,传输完成后,电脑向设备发送 VERIFY 指令,这时设备对已经写入 Flash 的数据进行 CRC 校验并与 Header 中声明进行比较,不通过时返回 CRC mismatch。
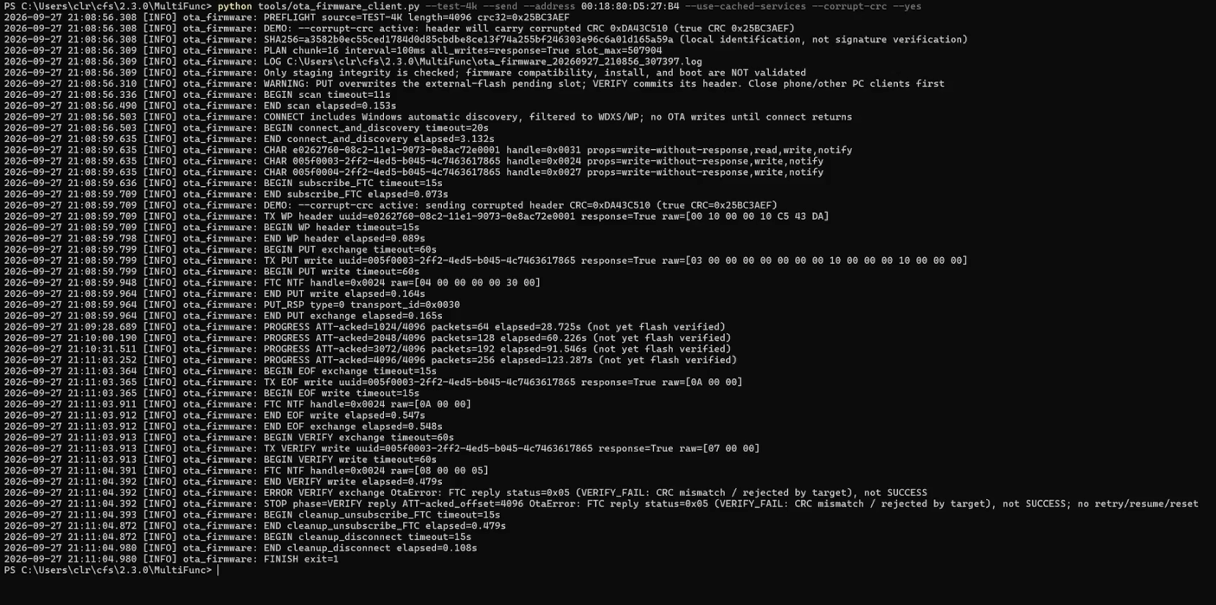
这里返回了符合预期的状态码,CRC 校验不通过。
但由于蓝牙 PHY 适配得仍然不完美,导致蓝牙传输的速率非常缓慢,传输完整的固件(~500kB)会非常吃力,只能达到功能验证和链路验证意义上的相对可用状态。
五、遇到的主要问题
5.1 RISC-V BLE 协议栈与 PHY 适配
MAX32655 内部集成 Cortex-M4F 与 RISC-V 双核,其中 RISC-V 可用于承担 BLE Controller、Baseband 与 PHY 等对实时性要求较高的无线任务。但在实际开发中发现,当前 MSDK 并没有提供以 RISC-V 作为 BLE 无线处理核心的完整示例,官方示例主要以 Cortex-M4F 路径为主,因此本项目需要自行完成 RISC-V BLE 的启动、资源配置(需要给riscv 分配 WUT 和 TMR 外设)、Mailbox 双核通信以及 PHY 适配。
进一步分析 MSDK git log 后发现,本项目所使用的 MAX32655 为 Rev B1 硅片版本。ADI 已针对 RevB 更新 Cortex-M4F 侧的 libphy,而 RISC-V 版本仍保留较早的 A1 实现。对 ARM-old、RV-old 与 ARM-RevB 三套 PHY 实现进行比较后,可以看到 RevB 在 DBB 事件处理、TX/RX 完成逻辑、射频初始化、Trim、时序控制等多个位置均进行了修改,这意味着旧版 RISC-V PHY 并不能简单假定能够直接运行在 RevB 硬件上。
项目初期首先采用了覆盖式修补的方法:不直接修改原始静态库,而是在应用工程中重新实现并覆盖若干关键 PHY 函数,将已经确认的 RevB 修正逐步加入 RISC-V 路径。这种方式便于快速验证单个假设,也成功排除了部分明显的事件清除、初始化和时序问题。然而,虽然广播能够开始运行并维持一段时间,系统仍会在较长时间运行后出现无线任务停止推进的现象,说明问题并不局限于少数几个函数。
随后项目转而采用更彻底的方法:对 M4 RevB libphy 与旧版 RISC-V libphy 进行反汇编和伪 C 对比,以 ARM-old / RV-old / ARM-RevB 三栏方式梳理差异,并将 RevB 相关修改系统性迁移到 RISC-V 实现中。适配范围不再局限于单个 TX 路径,而是进一步覆盖 DBB EVENTS 处理、TX/RX 完成事件、PHY 初始化、射频配置、时序参数及相关状态机逻辑,希望使 RISC-V PHY 尽可能接近官方 RevB 的实现。
但即使完成这一轮较全面的 RevB 适配,长时间运行中的 ble freeze 仍未完全消失。为进一步定位问题,随后又在 BbExecute、信道切换、PalBbBleTxData、TX submit、DBB event、TX done、Timer/WUT 以及 Mailbox 等关键位置加入运行审计。测试结果能够确认:BLE Controller 的调度链路、37/38/39 三个广播信道以及实际 PHY 发包均能够正常工作,连接建立后 GATT Notification 也可以正确传输,因此 M4 → Mailbox → RISC-V → BLE Controller → PHY → 手机/电脑 的整体链路已经基本打通。
后续实验进一步发现,极端情况/长时间广播等情况下的 late-TX 或发送完成事件丢失仍可能导致无线状态机停止推进。项目曾通过增加发送前时序保护和 guard 等方式改善稳定性,但在较长时间 BLE 连接和 OTA 传输中仍可能出现 freeze。因此,目前 RISC-V BLE 已经达到了功能验证和链路验证意义上的相对可用状态:广播、连接、GATT Notify 以及 OTA 数据传输均能够实际运行,但距离真正可长期部署的产品级稳定性仍有一定距离。
此外,由于目前为了规避底层时序边界问题,需要采用较保守的发送策略和较大的保护余量,实际 BLE 数据吞吐率也远低于正常 BLE 链路应达到的水平,OTA 固件传输尤其耗时。因此,本项目最终验证了 MAX32655 RevB 上 RISC-V BLE 路径的技术可行性和双核协同链路,但稳定性和传输效率仍是后续需要继续优化的主要问题。
5.2 调试器串口缓冲区与日志异常
MAX32655FTHR 板载调试器提供了USB CDC 串口功能,项目开发过程中大量依赖其输出 BLE、传感器、Edge AI 以及 OTA 调试信息。但在长时间运行和高频日志输出过程中发现,板载调试器的 CDC 串口存在较明显的缓冲行为,表现为:串口工具关闭一段时间后再次打开,会一次性收到此前积压的数据,并且有时出现连续的 *** 等异常内容;而在串口始终保持打开时,没有异常内容。
进一步分析后确认,异常内容的出现与串口关闭期间的日志产出量有关,日志较少时重新打开会一次性收到此前积压的数据,但不会有异常 ***,日志较多则重新打开后收到的内容都为 ***。
最终项目采用了串口常开 + 本地 TCP 桥接的方式规避这一问题。独立的 serial_bridge.py 在启动后始终占用并保持打开板载 CDC 串口,由专门的读取循环持续 drain UART 数据,并在 PC 内维护固定大小的环形缓冲区;其他分析工具不再直接打开物理 COM 口,而是通过 127.0.0.1:8765 连接串口桥。即使上层客户端暂时断开、处理速度较慢或重新连接,物理串口也不会被关闭,底层数据仍会被持续读取。当缓存达到上限时优先丢弃最旧的历史数据,从而避免无界积压。
这种设计同时解决了多个调试问题:一方面避免了 Windows 程序和调试器反复打开、关闭 CDC 端口带来的异常行为;另一方面允许多个自动化分析脚本统一通过本地 TCP 接口访问串口,而不需要争抢物理串口设备。
后续发现更新板载调试器到最新版本后也不再有异常。
5.3 flash 内存占用
随着 RISC-V BLE、传感器、LoRa、OLED、Edge AI 和 OTA 功能逐步加入,MAX32655 芯片内部 Flash 很快接近上限。早期完成 RISC-V BLE Bring-up 时,M4 固件已达到约 254668 / 262144 B,使用率约 97.15%,剩余空间仅约 7.3 KiB,继续直接加入 AI 模型和 OTA 功能存在明显空间压力。
这一问题在加入 Magic Wand 模型后更加突出。模型本身约 10,248 B,已超过当时 M4 的剩余空间。因此项目最终没有继续将模型直接编译进内部 Flash,而是利用板载外部 QSPI Flash,为 Edge AI 划分独立 Model Slot。模型启动时从外部 Flash 读取并校验后加载到 SRAM,生产构建中的 .bin_storage 保持为空,从而释放约 10 KiB 内部 Flash。
同时,外部 Flash 还划分了独立的 OTA Pending、Recovery、Metadata、Model Slot 和用户数据区域。OTA 暂存完整的 M4 + RISC-V 固件镜像,由 Bootloader 校验后再写入内部 Flash,使大容量镜像和 AI 模型均不再直接挤占有限的 M4 程序空间。

 john小天1
 豆腐Orz
