
2026 ADI CodeFusion 竞赛 —— 基于 MAX32655-FTHR 实现离线中文关键词唤醒与命令词识别
1 所选任务
赛道一(边缘计算),【入门级题目2:关键词唤醒与命令词识别】
任务要求使用板载音频输入实现 3~5 个预设关键词的离线识别,识别响应延迟 500ms 以内,并根据识别结果控制 LED 等外设。本项目完成情况对照如下:
任务要求 | 完成情况 |
|---|---|
3~5 个预设关键词 | 4 个中文命令词:开机、关机、增加、减少 |
板载音频输入离线识别 | 板载数字麦克风 → MAX9867 → I2S 采集,端侧 int8 神经网络推理,全程无网络、无上位机依赖 |
识别响应延迟 ≤ 500ms | 推理节拍 40ms + 4 帧概率平滑(约 160ms),命令延迟约 200ms 量级 |
控制外设动作 | 识别成功后:RGB LED / 外接指示灯按命令词以对应颜色/闪烁模式指示;从 microSD 播放对应 WAV 语音回应;系统待命/反馈状态由 MAX20303 PMIC 的绿色 LED 指示 |
指定开发调试工具 | 固件工程基于 CodeFusion Studio 2.2.1(MSDK + arm-none-eabi-gcc)开发、编译、烧录与调试 |
2 项目描述
2.1 系统概述
本项目在 MAX32655FTHR 开发板上实现了一个离线中文命令词识别与反馈系统:设备待命时持续监听板载麦克风输入,用户说出"开机 / 关机 / 增加 / 减少"四个命令词之一后,开发板在数百毫秒内完成识别,并通过 LED 与语音播放做出回应。整个链路包括数据采集、模型训练量化、嵌入式部署三部分,全部自主开发:
- 数据采集:先用开发板自制录音采集固件(附录A),采集 298 条中文命令词录音,存入 microSD 卡;
- 模型训练与量化:在电脑端用 PyTorch 完成轻量级 DS-CNN(深度可分离卷积网络)训练,经量化感知训练(QAT)转为 int8,并自动生成 CMSIS-NN C 源码(模型权重、前端查找表、量化参数),提供各步骤的操作指令(附录B);
- 嵌入式部署:在 CodeFusion Studio 中开发 MAX32655 固件,通过 I2S + DMA 实时采集音频,CMSIS-DSP 计算 Log-Mel 特征,CMSIS-NN 完成 int8 推理,判决后驱动指示灯、microSD WAV 播放与 UART 上报。
由于数据集协议原因,完整音频数据集不公开。如有需要,请使用录音采集固件,自行构建数据集。
2.2 交互效果
- 待命状态:MAX20303 PMIC 绿色 LED 常亮,表示系统正在监听,可以处理语音指令;
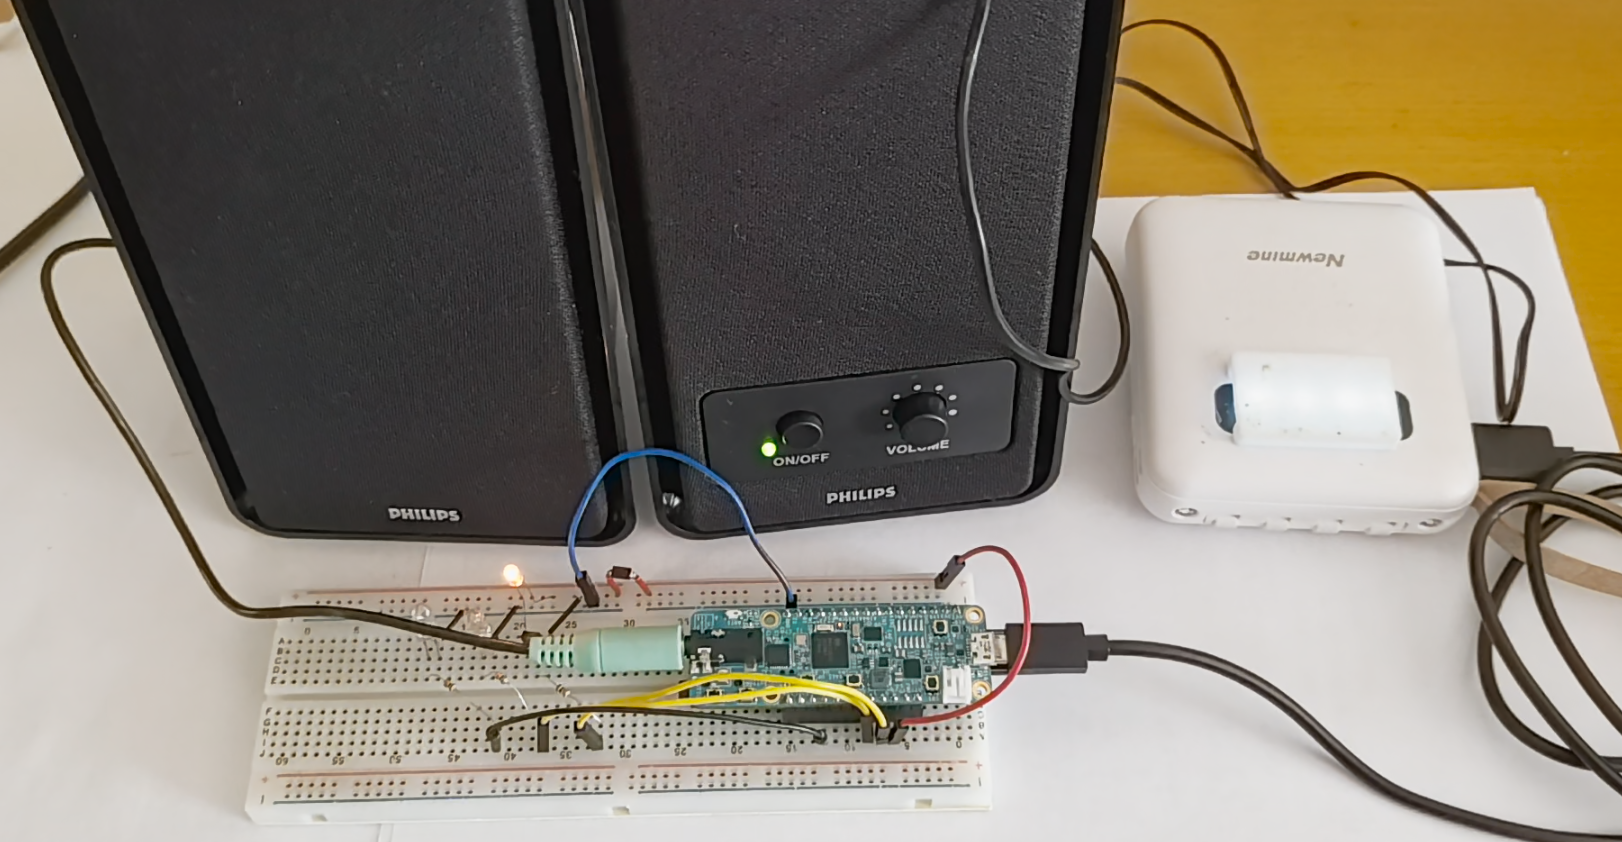
- 识别到命令词:绿色待命 LED 熄灭,开发板上的 RGB LED 按命令词以对应颜色闪烁(开机=绿色常亮 1s;关机=红色闪烁;增加=青色快闪;减少=品红闪烁),开发板外接的指示灯同步闪烁(开机=灯泡点亮,增加=红色 LED 闪烁,减少=蓝色 LED 闪烁,关机=灯泡熄灭),同时通过 I2S 播放 microSD 中对应的 WAV 回应语音(已经启动/已经增加/已经减少/已经关闭);
- 回应结束:自动清空音频缓冲、重置识别状态,重新启动采集并点亮待命 LED,回到监听状态;
2.3 关键指标
指标 | 数值 |
|---|---|
命令词数量 | 4(开机/关机/增加/减少)+ 2 个拒识类(静音/未知) |
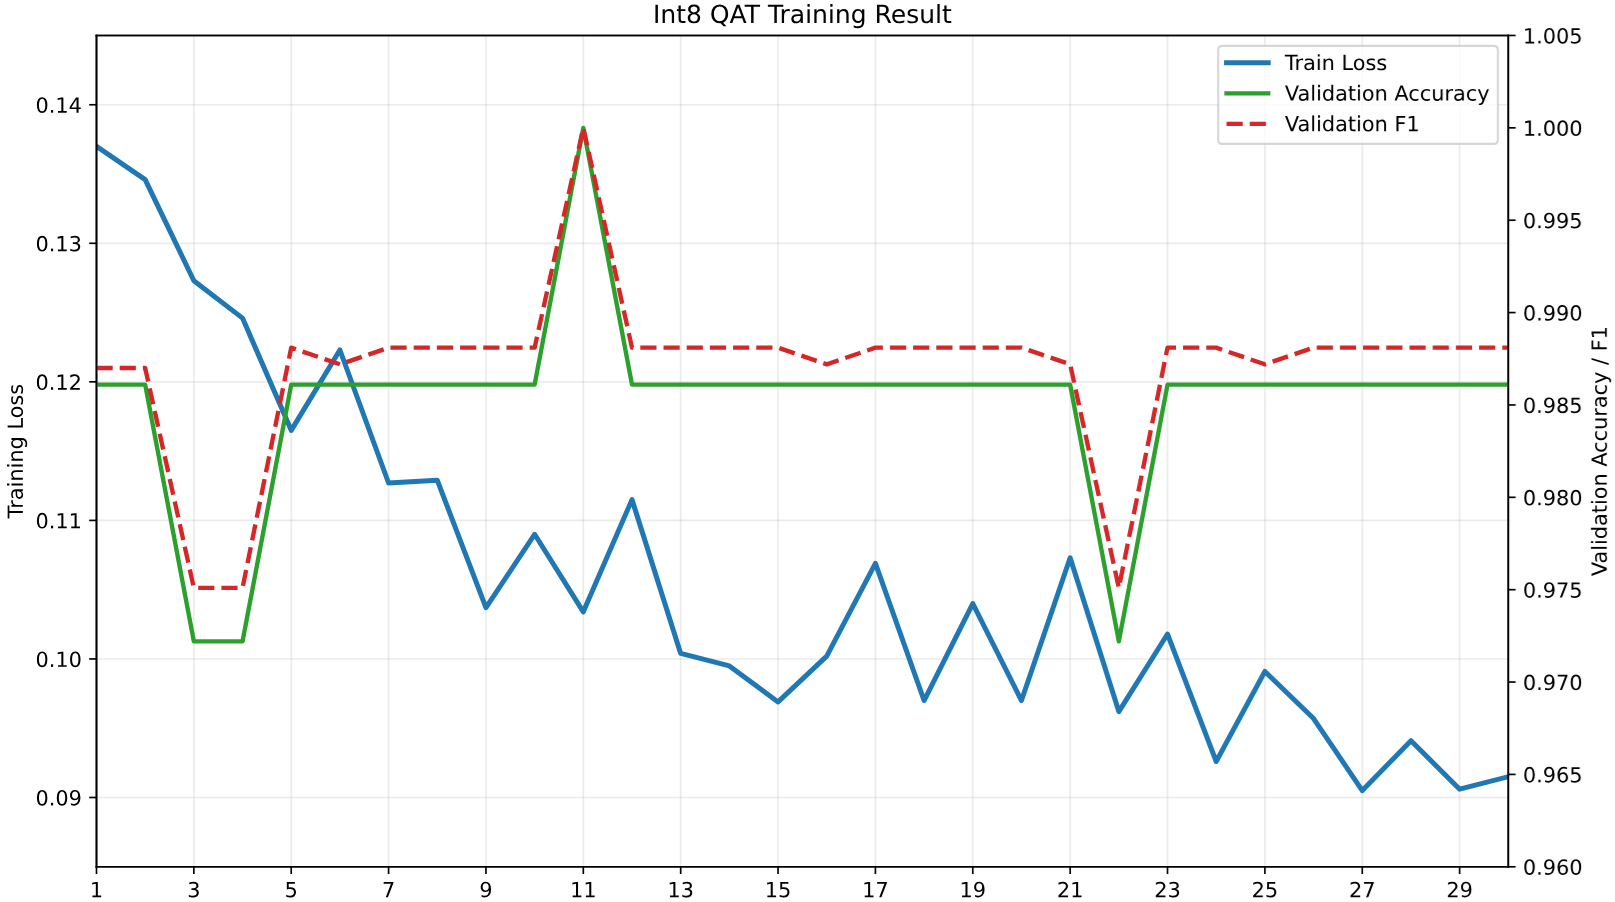
int8 模型验证集准确率 | 98.61%(macro F1 98.81%) |
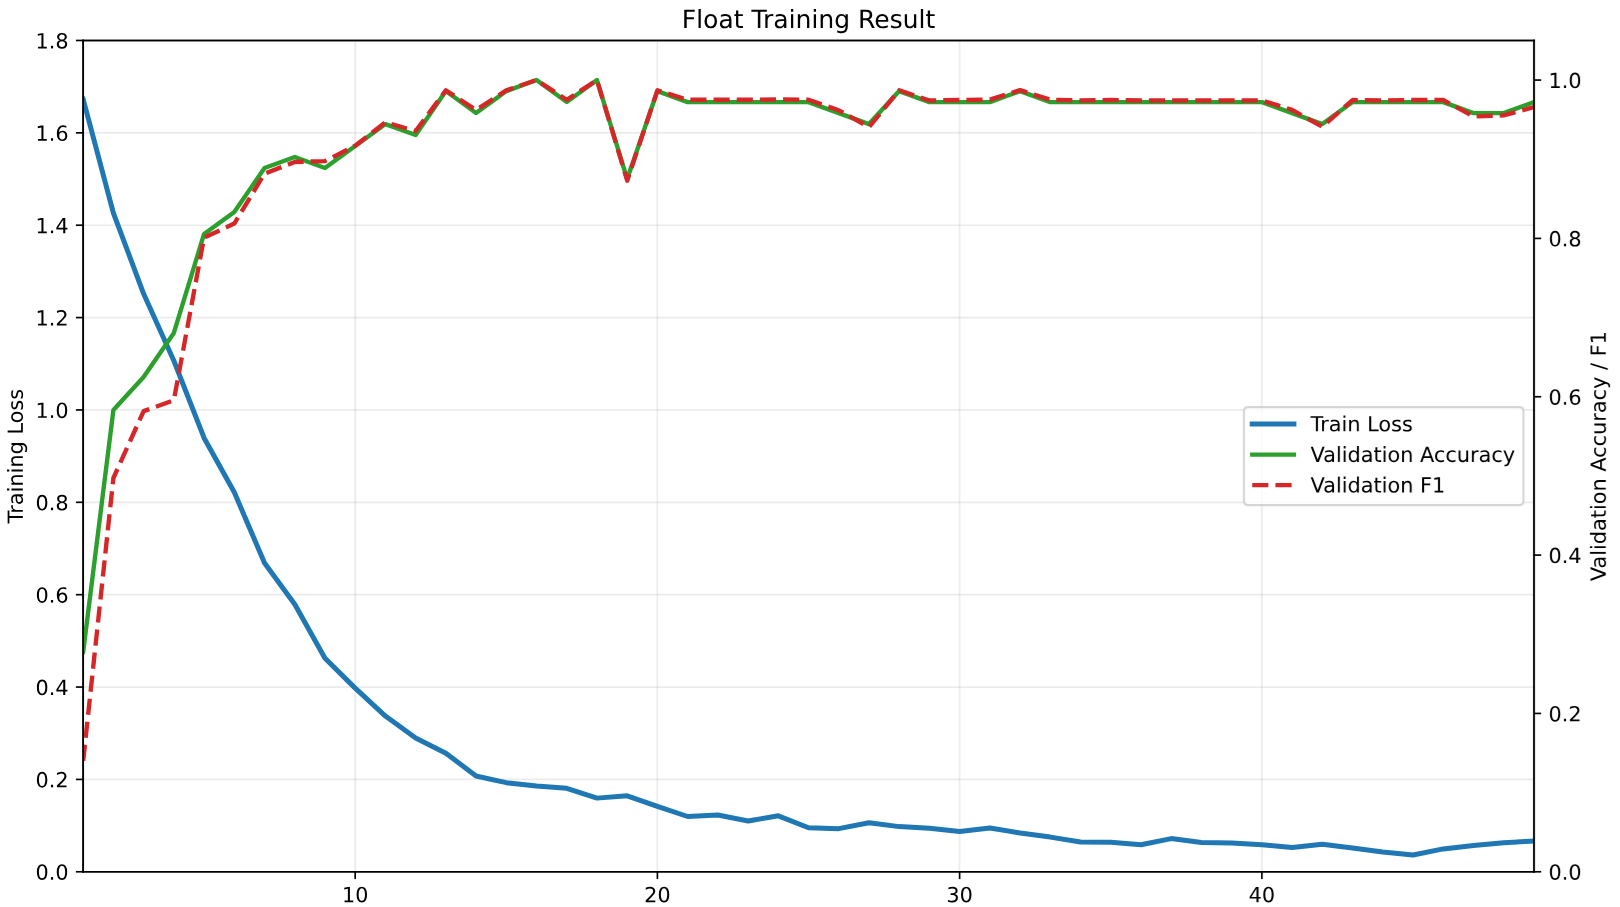
float32 模型验证集准确率 | 97.22%(macro F1 96.59%) |
模型参数量 | 约3.7K |
推理节拍 / 上下文窗口 | 40ms 一次推理 / 80 帧 ≈ 1.6s 滚动窗口 |
识别响应延迟 | 约 200ms 量级(40ms 节拍 + 160ms 平滑窗) |
反馈种类 | 2种(声音、灯光) |
3 硬件介绍
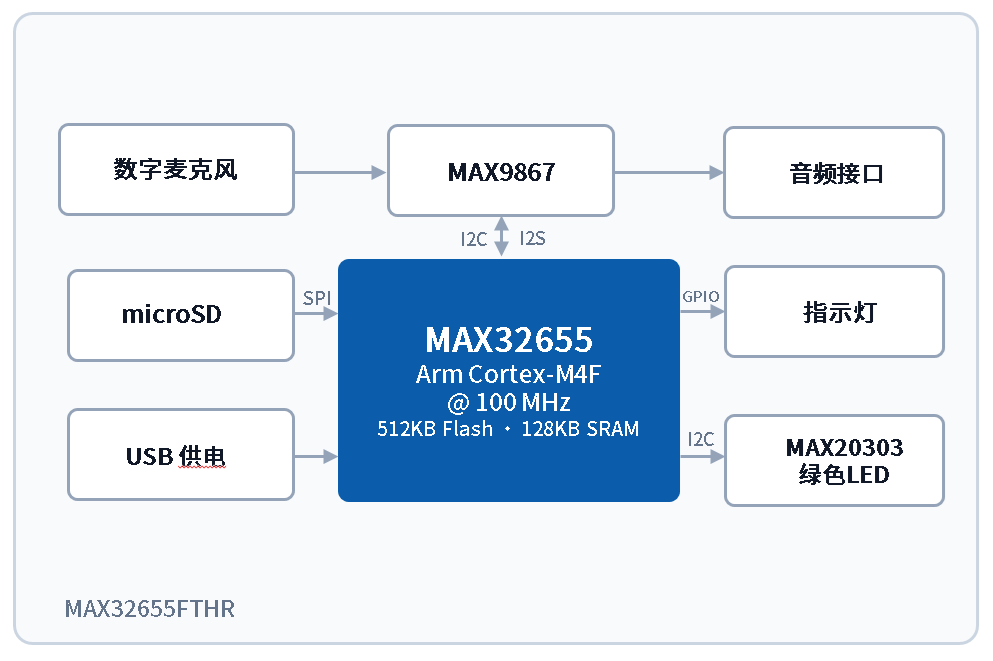
本项目使用 MAX32655-FTHR 评估板,未设计自定义 PCB。主控 MAX32655:Arm Cortex-M4F 内核,主频 100MHz(带 FPU 与 DSP 指令),512KB flash、128KB SRAM,集成 BLE 5.2 无线电(含 RISC-V 协处理器)。本项目仅使用 ARM MCU 部分,算力与存储均满足需求。
板载资源(本项目用到部分):
功能 | 板上器件 / MCU 外设 | 关键配置 |
|---|---|---|
声音采集 | 板载数字麦克风 + MAX9867 音频编解码器 | I2C 地址 0x18 配置;MCLK 12.288MHz;采样率 16kHz;数字麦克风右通道输入;ADC 增益 +3dB |
音频数据传输 | MAX32655 I2S + DMA | 单声道右通道、16bit;RX 采用 ping-pong 双缓冲(2×640 样本,每块 40ms);TX 用于 WAV 播放 |
命令指示 | 板载 RGB LED(P0.18 红 / P0.19 绿 / P0.26 蓝) | 低电平点亮,GPIO 直接驱动 |
待命指示 | MAX20303 PMIC 绿色 LED | 经 I2C 控制,监听时常亮、反馈时熄灭 |
语音回应播放 | microSD 卡座(SPI:CS=G9、MISO=G7、MOSI=G8、SCK=H9)+ FatFs 库函数 | SD卡的根目录存放 OPEN/CLOSE/INCR/DECR 四个 WAV 文件 |
神经网络算力 | CMSIS-NN 7.0.0 + CMSIS-DSP 库,无NPU | int8 卷积/全连接算子与 512 点 RFFT |
调试接口 | 板载 DAPLink + UART0 | UART0 115200-8-N-1 输出识别日志 |
外接器件:
GPIO引脚 | 外接器件 | 具体含义 |
|---|---|---|
P1.6 | 5V 灯泡,由 9018 三极管驱动 | 开机指示灯(点亮=开机,熄灭=关机) |
P1.7 | 红色 LED | “增加”指示灯(闪烁=增加) |
P1.8 | 蓝色 LED | “减少”指示灯(闪烁=减少) |
4 方案框图与设计思路
4.1 系统方案框图
4.2 端到端机器学习流水线
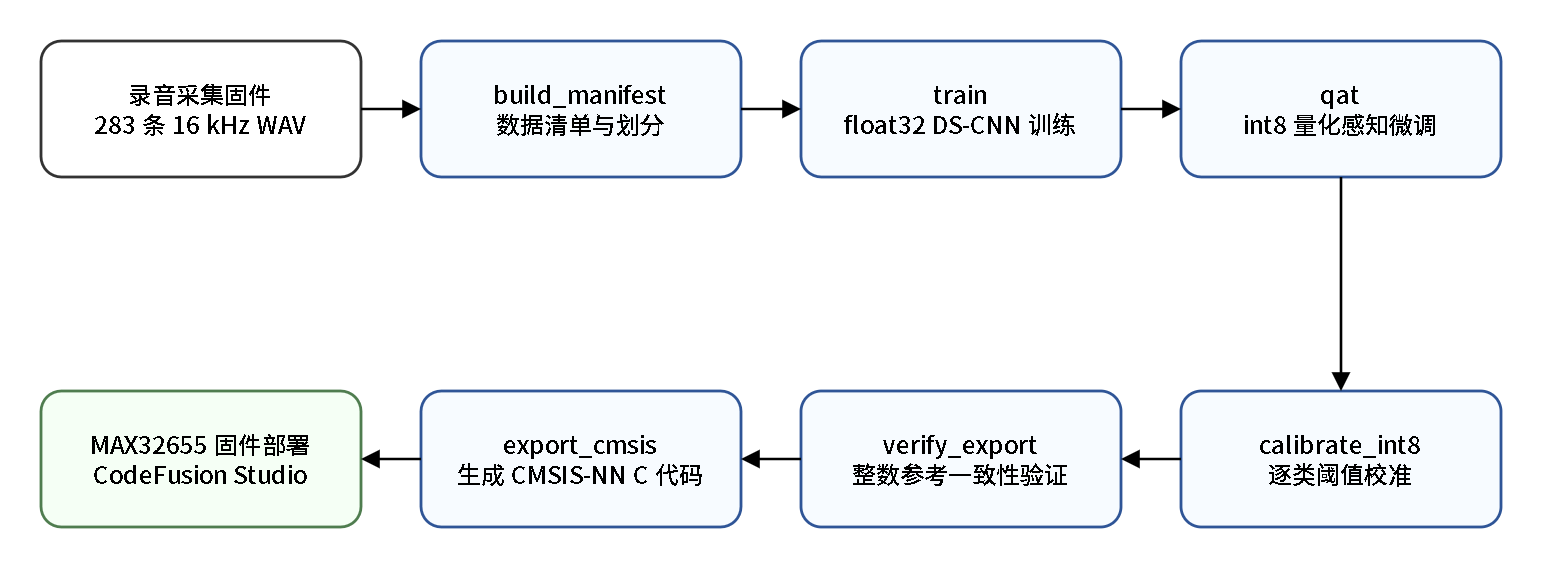
训练与部署工具链按"采集 → 训练 → 量化 → 校准 → 验证 → 导出 → 部署"组织,每一步均有独立脚本与产物,保证流程可复现:
4.3 关键设计决策
- Tiny DS-CNN 网络结构:输入 80 帧 × 32 频带 Log-Mel 谱,主干为 1 个 3×3 步长 2 的 stem 卷积 + 4 组 depthwise/pointwise 深度可分离卷积块(通道 8→16→24→32→32),全局平均池化后接 6 类全连接分类器。深度可分离卷积大幅降低计算量,全模型参数量约 3.7K ,int8 权重约 3.3KB,适配 MAX32655 的 512KB flash 与 128KB SRAM。
层 | 类型 | 核/步长 | 输出形状 |
|---|---|---|---|
输入 | — | — | 1×80×32 |
stem | 卷积 | 3×3 / 2×2 | 8×40×16 |
block1 | DW+PW | 3×3, 1×1 | 16×40×16 |
block2 | DW+PW | 3×3(2×2), 1×1 | 24×20×8 |
block3 | DW+PW | 3×3(2×1), 1×1 | 32×10×8 |
block4 | DW+PW | 3×3, 1×1 | 32×10×8 |
分类头 | GAP + FC | — | 6 |
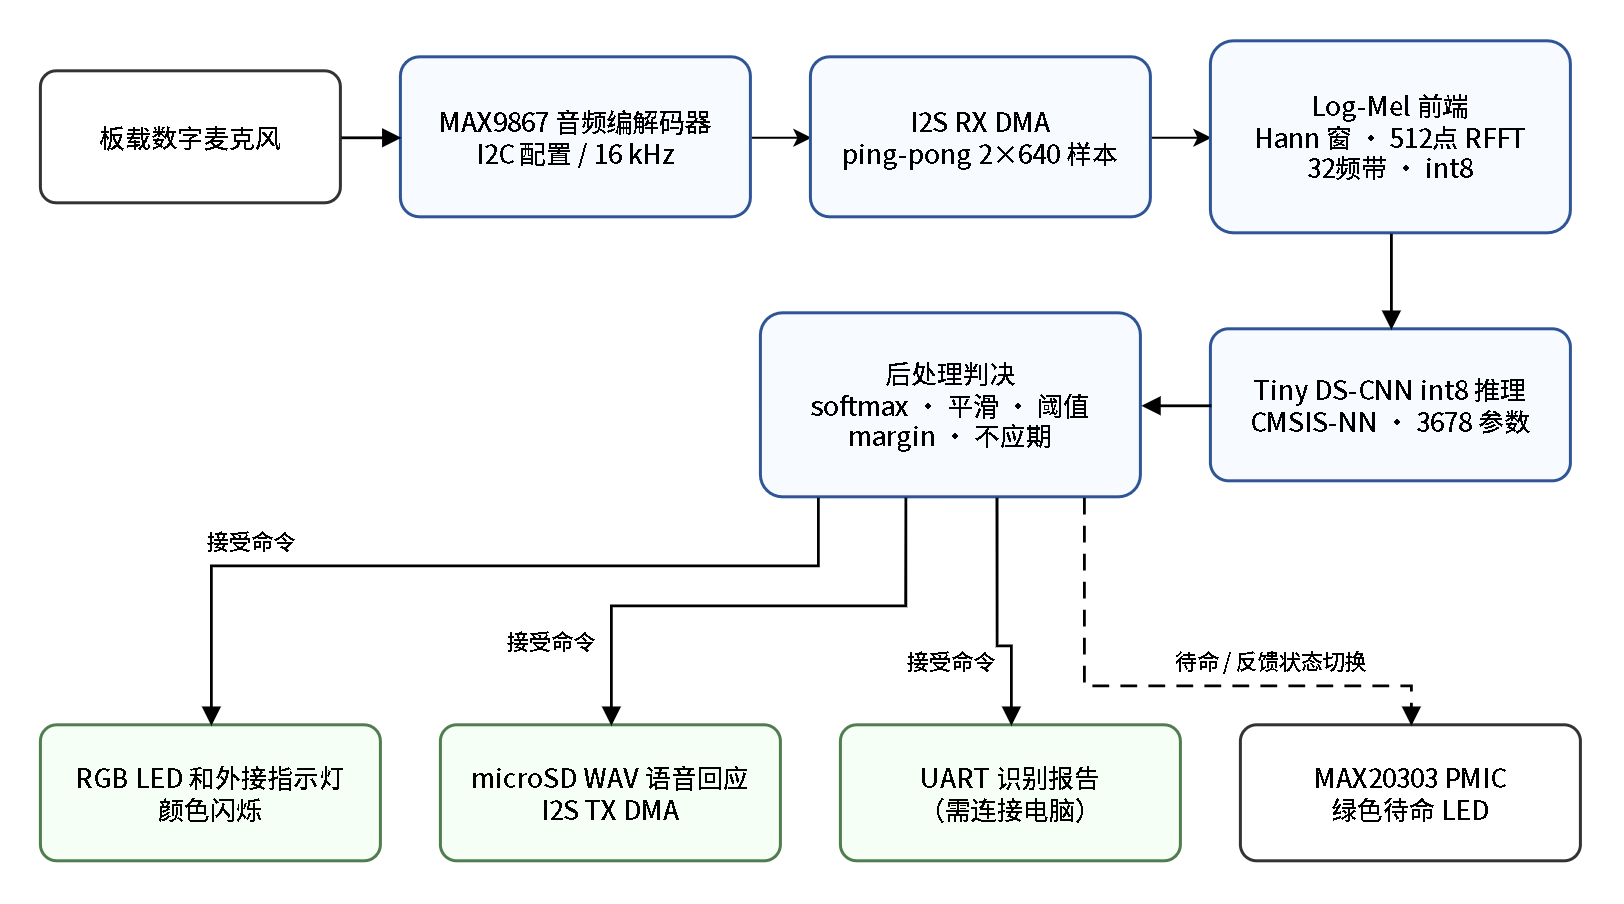
- Log-Mel 前端,训练端与部署端严格一致:帧长 25ms(400 样本)、帧移 20ms(320 样本)、512 点 FFT、32 个 Mel 频带(80~7600Hz)、80 帧上下文(约 1.6s)。训练侧(Python)与固件侧(C,CMSIS-DSP
arm_rfft_fast_f32)使用同一套由 Python 导出的查找表(Hann 窗、Mel 滤波器组、特征均值/方差、输入量化参数),从源头上消除两端口径差异;特征最终量化为 int8。 - 实时推理节拍:音频以 640 样本(40ms)DMA 块到达,每块最多产生 2 个新帧并写入 80 帧滚动历史;每 40ms 截取当前上下文做一次 int8 推理。启动约 1.6s 填满上下文后进入稳态,音频不丢块(ping-pong 双缓冲 + 超块计数监测)。
- 低误触发的判决链:softmax 概率 → 4 帧滑动平均(约 160ms)→ 命令类需超过逐类独立阈值(由校准脚本在验证集上自动确定)→ 与次优类的 margin ≥ 0.4 → 距上次接受 ≥ 500ms(不应期)。SILENCE/UNKNOWN 作为显式拒识类参与训练,非命令词语音会被主动拒绝而非强行归类。
- QAT 量化而非训练后量化:权重采用逐通道对称 int8、激活采用逐张量 int8、偏置 int32,BatchNorm 在导出前折叠进卷积。量化感知微调 30 轮后,int8 模型验证准确率 98.61%。
5 软件流程图、调试软件与关键代码
5.1 固件主流程
固件采用"DMA 中断 + 主循环"架构,无 RTOS。系统主频 100MHz,音频处理、推理、反馈全部在主循环中完成:
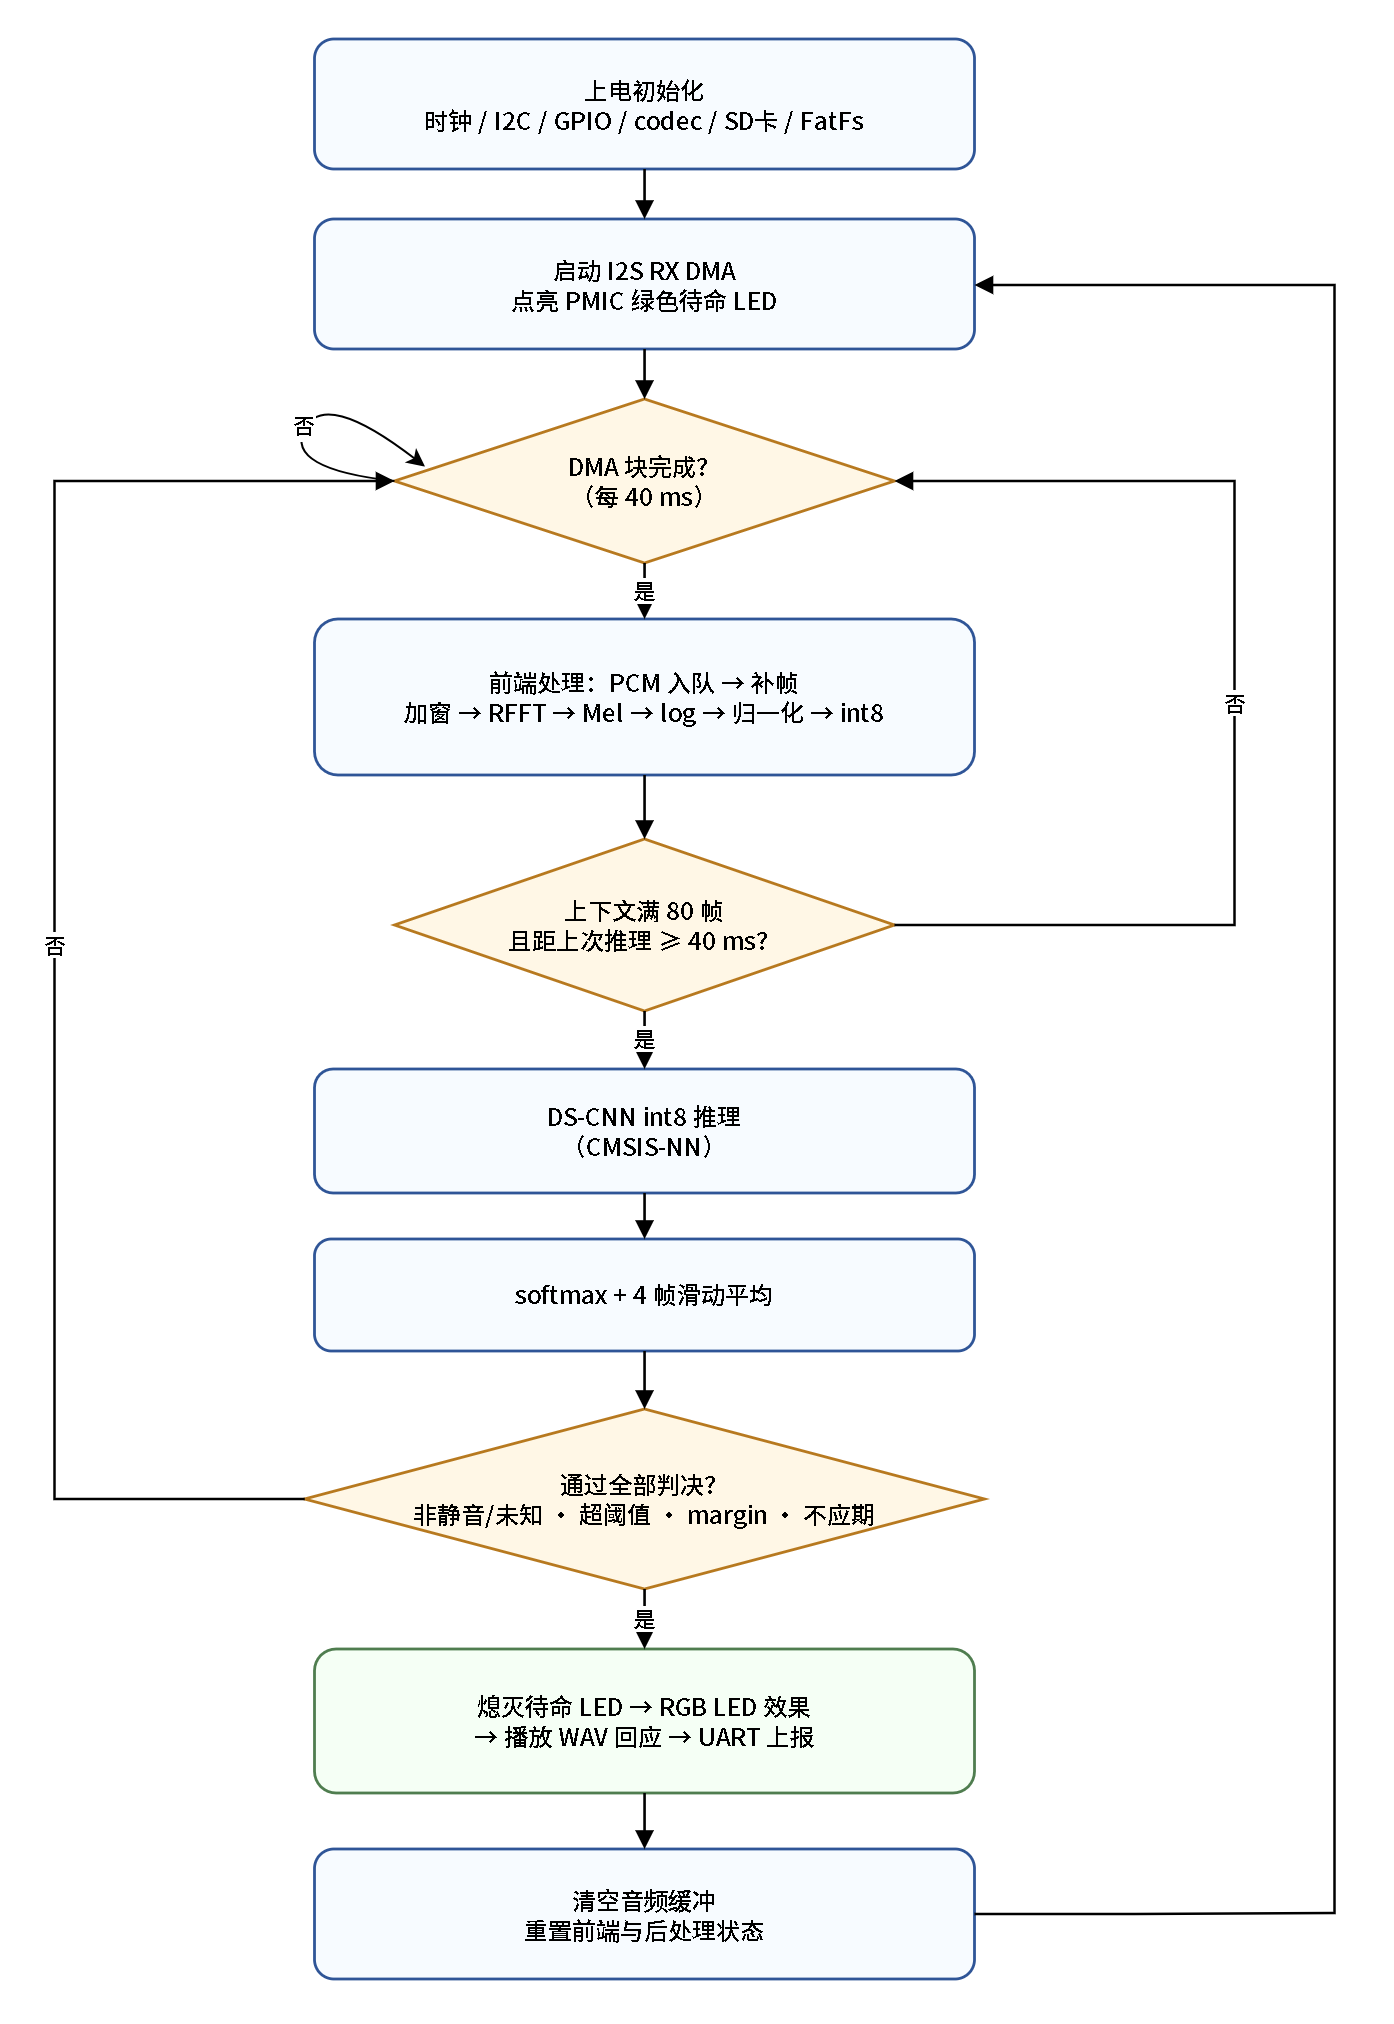
延迟预算分析:命令发音结束后,最迟 40ms(一个推理节拍)内概率开始上升,4 帧平滑窗约 160ms 完成确认,单帧推理与判决开销远小于一个音频块周期(固件内置超时监测,单块处理超过 40ms 会通过 UART 告警)。因此从发音结束到 LED/语音动作的延迟约 200ms 量级,满足题目 ≤500ms 的要求。
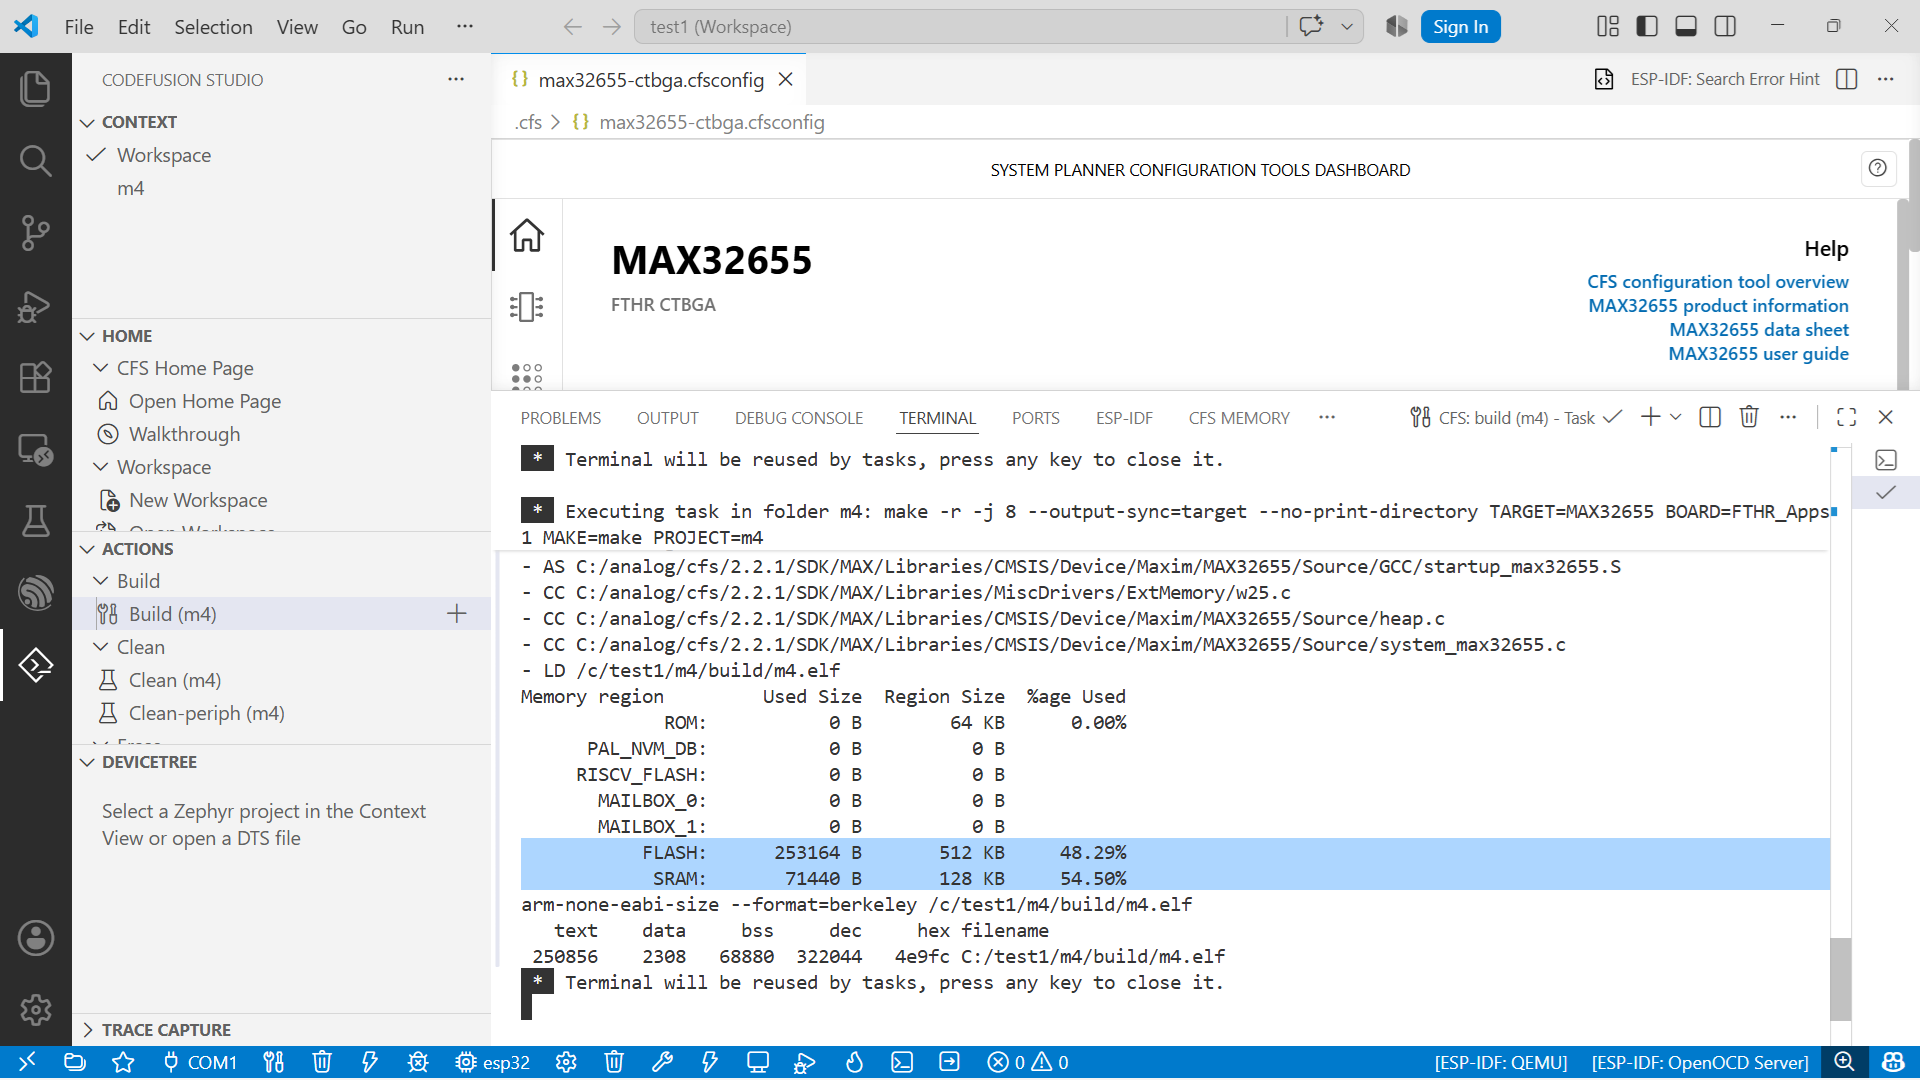
5.2 调试软件说明(CodeFusion Studio)
固件工程基于 CodeFusion Studio 2.2.1 开发调试,要点如下:
- 工程与构建:CFS 基于 VSCode 的嵌入式工作流,工程通过 CFS 图形化外设配置(
.cfsconfig)生成时钟、GPIO、I2C、I2S、UART、DMA 初始化代码;构建调用 MSDK 的 Make 体系(make release,arm-none-eabi-gcc,-O2优化),并启用ARM_MATH_CM4 / ARM_MATH_DSP与CMSIS_NN_USE_REQUANTIZE_INLINE_ASSEMBLY编译宏以充分发挥 Cortex-M4 的 DSP 指令与 CMSIS-NN 优化路径; - 烧录与调试:通过板载 DAPLink / J-Link 调试(目标 MAX32655),支持断点、单步、变量查看;SVD 文件支持外设寄存器级调试;
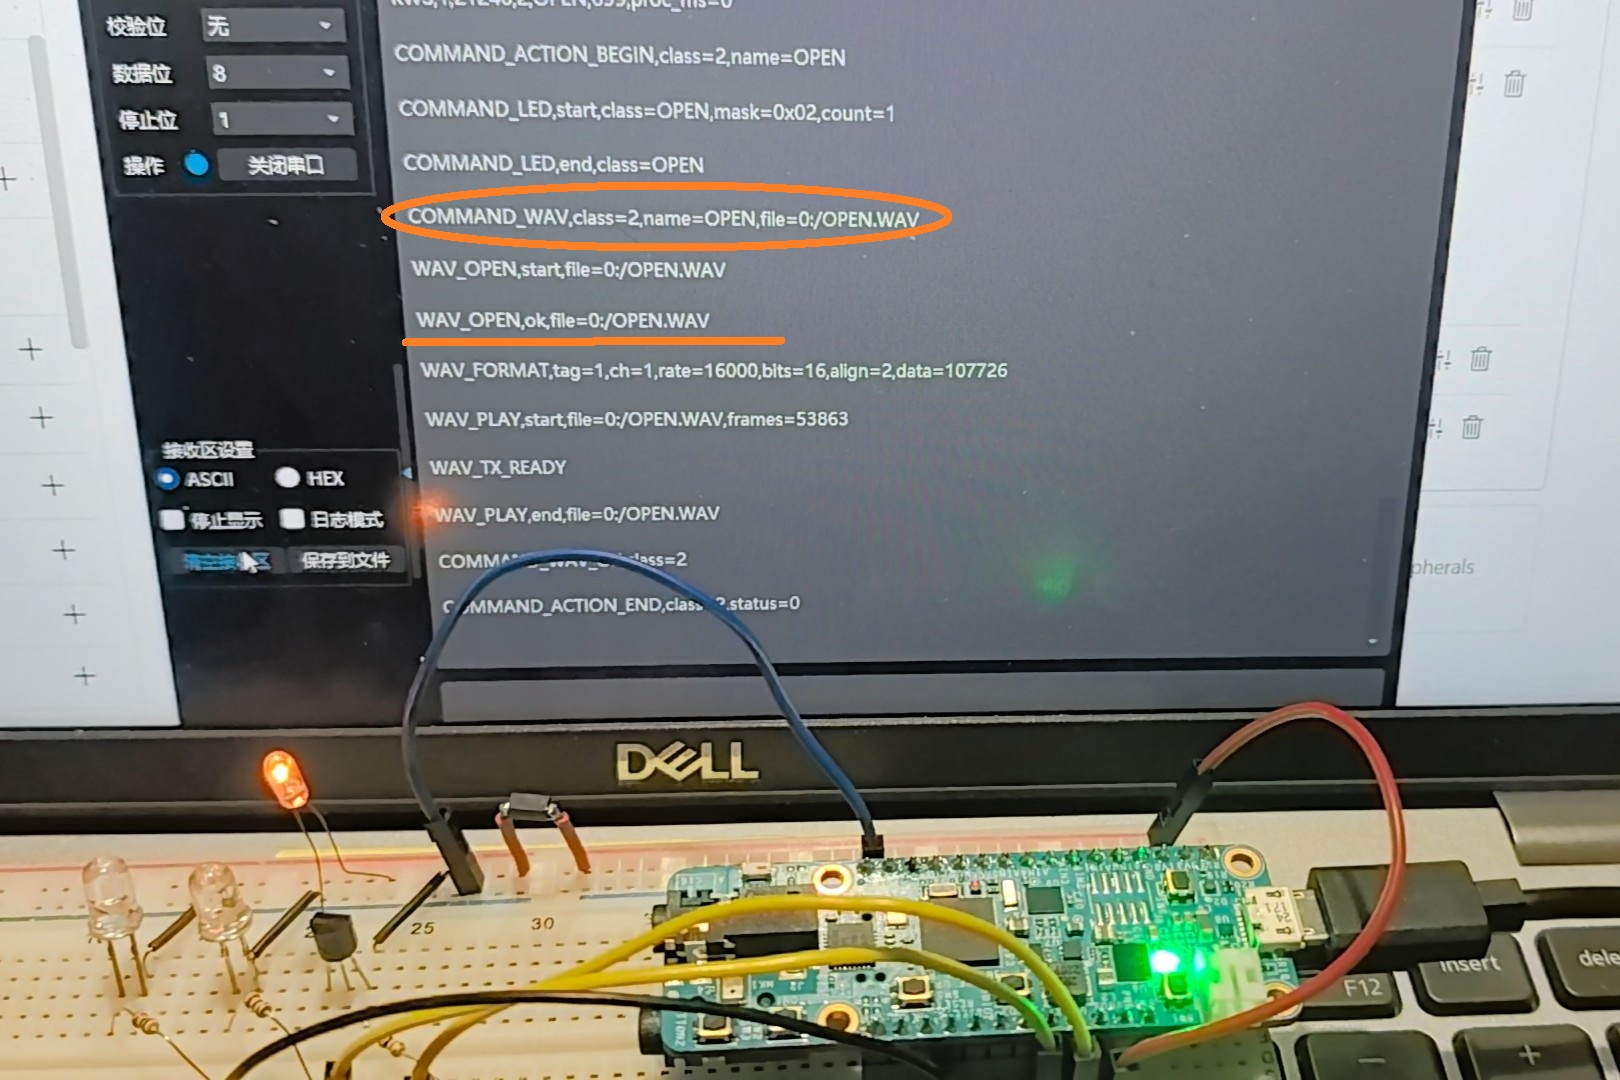
- 运行观测:UART0(115200-8-N-1)作为运行时观测通道,识别成功输出
KWS,<序号>,<时间戳ms>,<类别ID>,<类别名>,<置信度0~1000>,proc_ms=<单帧处理耗时ms>;调试模式下还可周期性输出各次判决的概率与拒绝原因(静音/未知/阈值/margin/不应期),便于联调阈值参数。

5.3 关键代码说明
(1)音频采集 —— audio/audio_stream.c
MAX9867 经 I2C 配置为 16kHz 主模式后,I2S 以单声道右通道接收 16bit PCM,DMA 配置为 ping-pong 双缓冲(2×640 样本):一块由硬件填充时,主循环处理另一块,块间无缝衔接,保证 40ms 音频流不丢样。DMA 完成回调仅置标志并统计 overrun,耗时处理全部留在主循环,中断开销最小化。
(2)神经网络前端 —— kws/nn_frontend.c
PCM 样本进入容量 1040 样本的 FIFO,每凑满 400 样本生成一帧:乘 Hann 窗 → CMSIS-DSP arm_rfft_fast_f32() 做 512 点实数 FFT → 功率谱 → 按 Python 导出的稀疏 Mel 表做 32 频带滤波 → 取对数 → 按导出的均值/方差归一化 → 按 q = x/scale + zero_point 量化为 int8,写入 80×32 滚动特征历史。所有查找表来自训练侧 frontend_tables.c,确保与训练完全一致。
(3)DS-CNN 推理 —— kws/dscnn_model.c
模型 10 层逐层调用 CMSIS-NN 7.0.0 算子:普通卷积与 1×1 卷积用 arm_convolve_wrapper_s8(),4 个 depthwise 层用 arm_depthwise_conv_wrapper_s8(),分类头前的全局平均池化用 arm_avgpool_s8(),最后用 arm_fully_connected_per_channel_s8() 输出 6 类 logits。权重/偏置/逐通道 multiplier 与 shift 均为 const 数组存放于 flash;推理使用 2×10KB 张量乒乓缓冲 + 4KB scratch,SRAM 占用受部署清单门限约束。
#define LAYER_DESC_CONV(prefix, w, b, m, s) \
    { \
        .op = DSCNN_OP_CONV, \
        .in_h = prefix##_IN_H, .in_w = prefix##_IN_W, .in_c = prefix##_IN_C, \
        .out_h = prefix##_OUT_H, .out_w = prefix##_OUT_W, .out_c = prefix##_OUT_C, \
        .kernel_h = prefix##_KERNEL_H, .kernel_w = prefix##_KERNEL_W, \
        .stride_h = prefix##_STRIDE_H, .stride_w = prefix##_STRIDE_W, \
        .pad_h = prefix##_PAD_H, .pad_w = prefix##_PAD_W, \
        .input_offset = prefix##_INPUT_OFFSET, .output_offset = prefix##_OUTPUT_OFFSET, \
        .act_min = prefix##_ACT_MIN, .act_max = prefix##_ACT_MAX, \
        .weights = (w), .bias = (b), .multiplier = (m), .shift = (s), \
    }


#define LAYER_DESC_DW(prefix, w, b, m, s) \
    { \
        .op = DSCNN_OP_DEPTHWISE, \
        .in_h = prefix##_IN_H, .in_w = prefix##_IN_W, .in_c = prefix##_IN_C, \
        .out_h = prefix##_OUT_H, .out_w = prefix##_OUT_W, .out_c = prefix##_OUT_C, \
        .kernel_h = prefix##_KERNEL_H, .kernel_w = prefix##_KERNEL_W, \
        .stride_h = prefix##_STRIDE_H, .stride_w = prefix##_STRIDE_W, \
        .pad_h = prefix##_PAD_H, .pad_w = prefix##_PAD_W, \
        .input_offset = prefix##_INPUT_OFFSET, .output_offset = prefix##_OUTPUT_OFFSET, \
        .act_min = prefix##_ACT_MIN, .act_max = prefix##_ACT_MAX, \
        .weights = (w), .bias = (b), .multiplier = (m), .shift = (s), \
    }


static const dscnn_layer_t g_layers[] = {
    LAYER_DESC_CONV(KWS_LAYER0_STEM,
                    kws_stem_weights, kws_stem_bias,
                    kws_stem_multiplier, kws_stem_shift),
    LAYER_DESC_DW(KWS_LAYER1_BLOCK1_DW,
                  kws_block1_dw_weights, kws_block1_dw_bias,
                  kws_block1_dw_multiplier, kws_block1_dw_shift),
    LAYER_DESC_CONV(KWS_LAYER2_BLOCK1_PW,
                    kws_block1_pw_weights, kws_block1_pw_bias,
                    kws_block1_pw_multiplier, kws_block1_pw_shift),
    LAYER_DESC_DW(KWS_LAYER3_BLOCK2_DW,
                  kws_block2_dw_weights, kws_block2_dw_bias,
                  kws_block2_dw_multiplier, kws_block2_dw_shift),
    LAYER_DESC_CONV(KWS_LAYER4_BLOCK2_PW,
                    kws_block2_pw_weights, kws_block2_pw_bias,
                    kws_block2_pw_multiplier, kws_block2_pw_shift),
    LAYER_DESC_DW(KWS_LAYER5_BLOCK3_DW,
                  kws_block3_dw_weights, kws_block3_dw_bias,
                  kws_block3_dw_multiplier, kws_block3_dw_shift),
    LAYER_DESC_CONV(KWS_LAYER6_BLOCK3_PW,
                    kws_block3_pw_weights, kws_block3_pw_bias,
                    kws_block3_pw_multiplier, kws_block3_pw_shift),
    LAYER_DESC_DW(KWS_LAYER7_BLOCK4_DW,
                  kws_block4_dw_weights, kws_block4_dw_bias,
                  kws_block4_dw_multiplier, kws_block4_dw_shift),
    LAYER_DESC_CONV(KWS_LAYER8_BLOCK4_PW,
                    kws_block4_pw_weights, kws_block4_pw_bias,
                    kws_block4_pw_multiplier, kws_block4_pw_shift),
};
(4)后处理判决 —— kws/kws_postprocess.c
logits 反量化后做数值稳定 softmax;对最近 4 次推理概率做滑动平均;依次检查拒识类、逐类阈值、与次优类的 margin(0.4)、500ms 不应期,全部通过才产出一次有效命令。逐类阈值由 PC 端校准脚本在验证集上自动生成并固化到固件。
(5)命令反馈 —— feedback/ 目录
command_actions.c:命令 → LED 效果映射(见第 6 节演示表),GPIO 直接驱动 RGB LED;sd_wav_player.c:FatFs 打开 microSD 上的 WAV,跳过文件头后经 I2S TX DMA 分块播放;pmic_ready_led.c:经 I2C 控制 MAX20303 绿色 LED 表达"监听中/反馈中"状态。
反馈期间会停止音频采集,播放结束后依次执行缓冲清空、前端/后处理状态复位、重新启动采集,避免回放音频被自身识别造成自触发。
(6)训练侧脚本链(PC 端,PyTorch 2.4.1)build_manifest(按 REC 编号区间生成标签清单并划分数据集)→ train(float 训练 + 早停)→ calibrate/qat(阈值校准与量化感知微调)→ calibrate_int8(int8 路径阈值校准)→ verify_export(float/伪量化/整数参考三方一致性验证)→ export_cmsis(生成 model_data.c、frontend_tables.c、model_config.h 与部署清单,直接落入固件工程 kws/generated/ 目录)。训练与部署之间零手工搬运:所有常量由脚本生成并带 CRC 校验。
6 实物演示及说明
CodeFusion Studio 软件截图请看 5.2章
演示流程(视频与照片均按此步骤录制):
步骤 | 操作 | 板上现象 |
|---|---|---|
1 | 上电启动 | PMIC 绿色待命 LED 点亮,进入监听 |
2 | 说"开机" | 绿色待命 LED 熄灭 → RGB LED 绿色常亮 1s → 播放开机回应语音 → 恢复监听 |
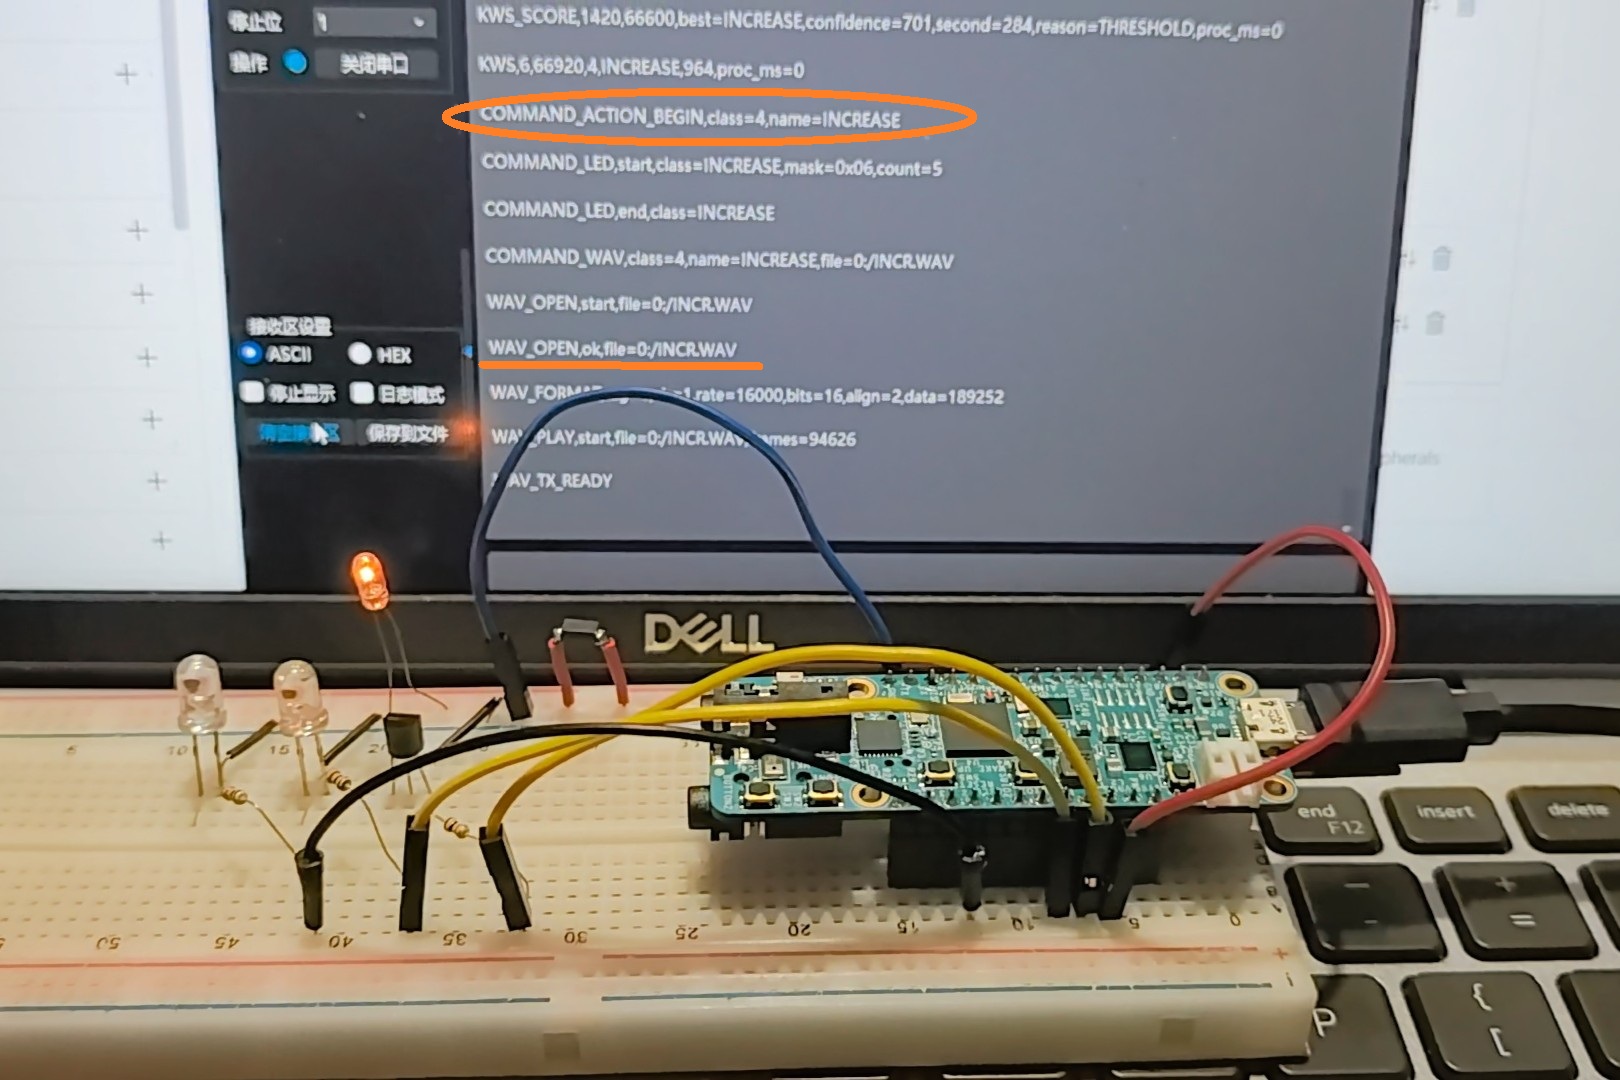
3 | 说"增加" | RGB LED 青色快闪(100ms 亮/灭 ×5)→ 播放增加回应语音 |
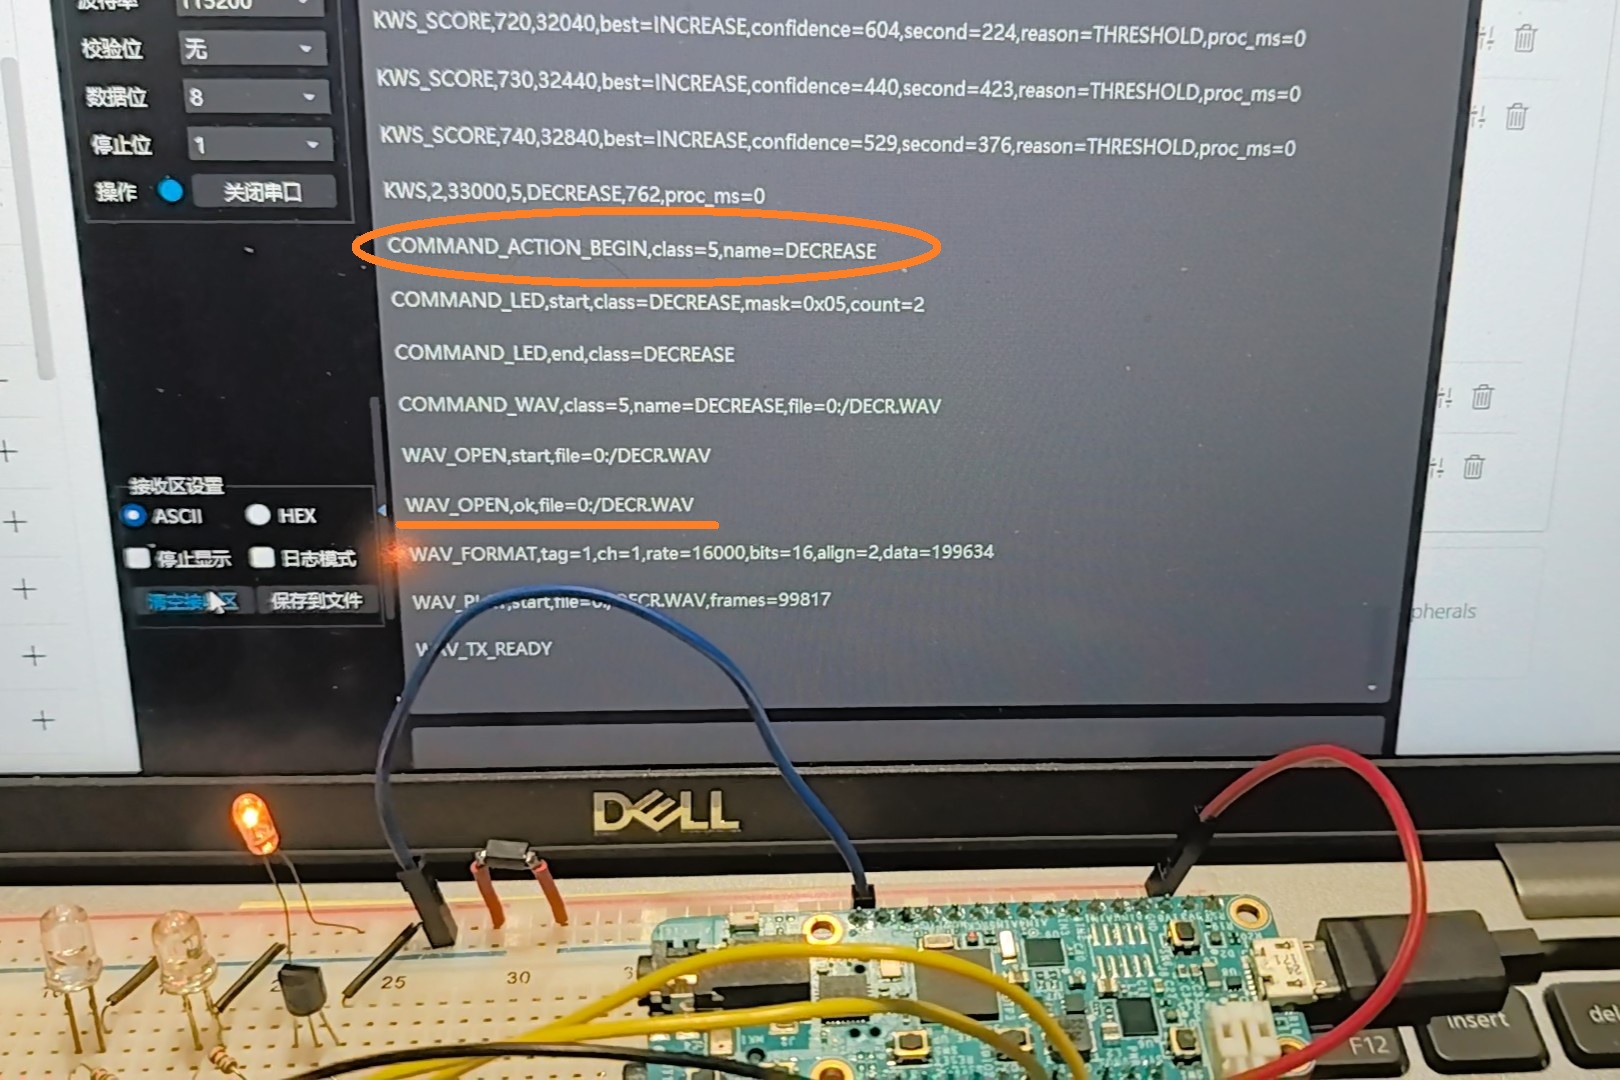
4 | 说"减少" | RGB LED 品红色闪烁(250ms 亮/灭 ×2)→ 播放减少回应语音 |
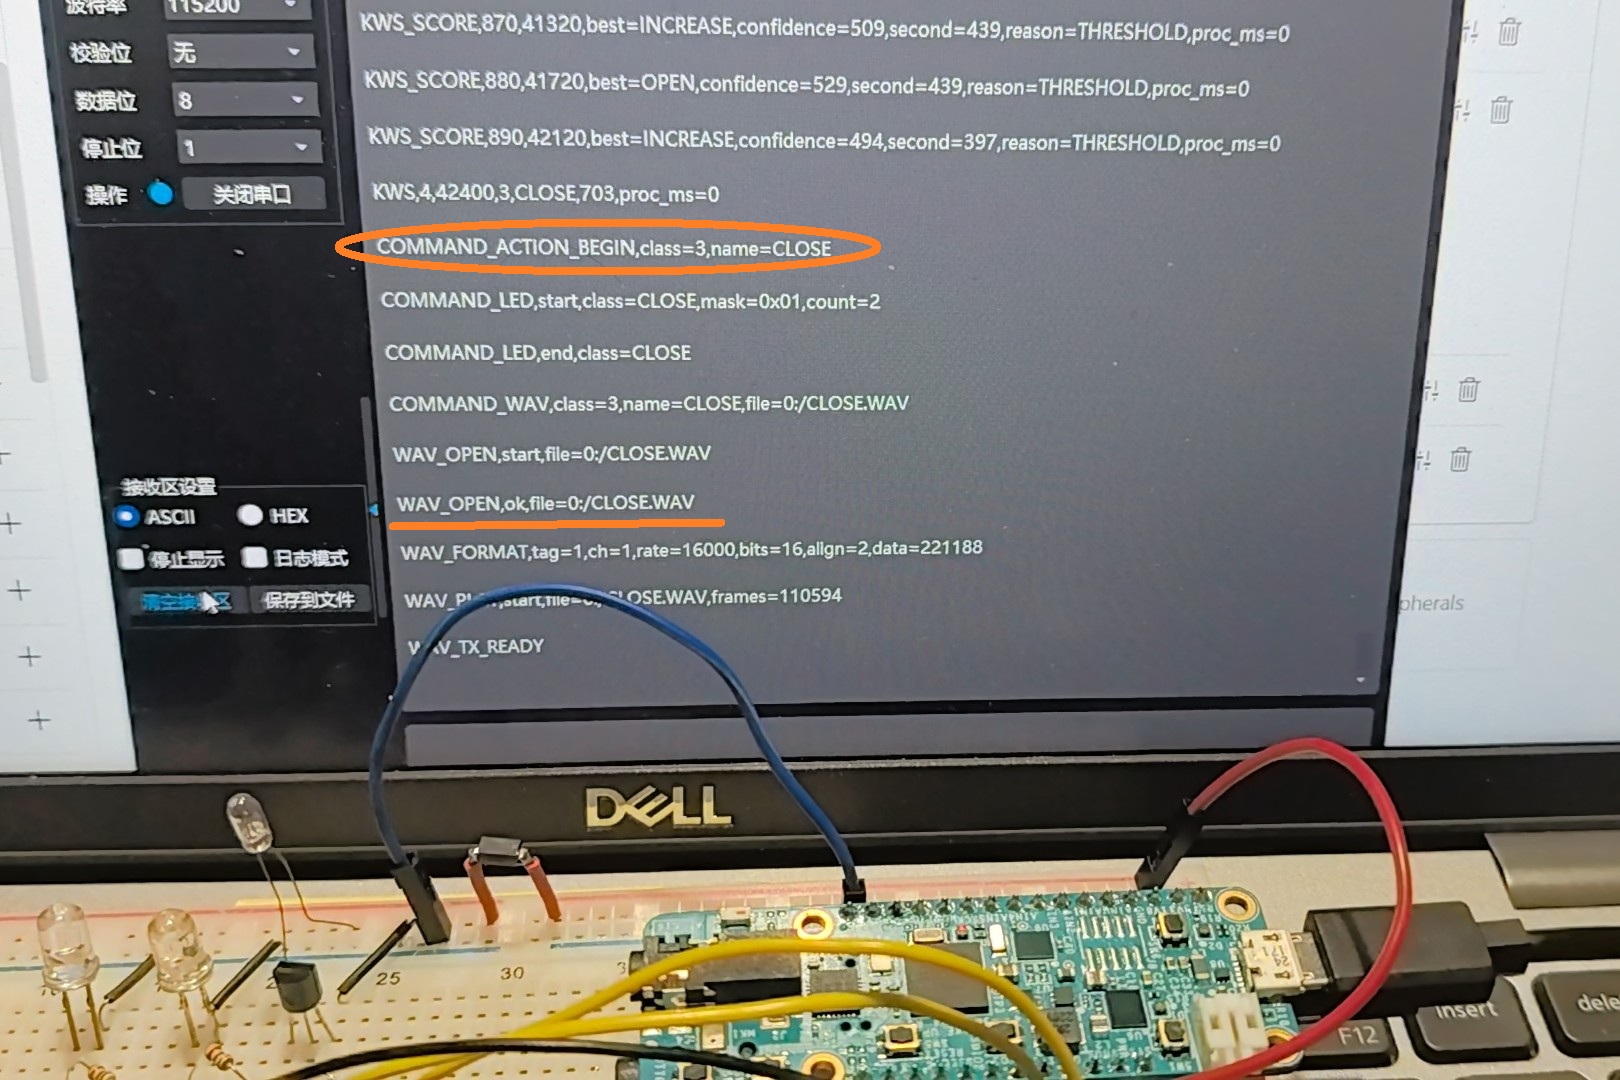
5 | 说"关机" | RGB LED 红色闪烁(250ms 亮/灭 ×2)→ 播放关机回应语音 |
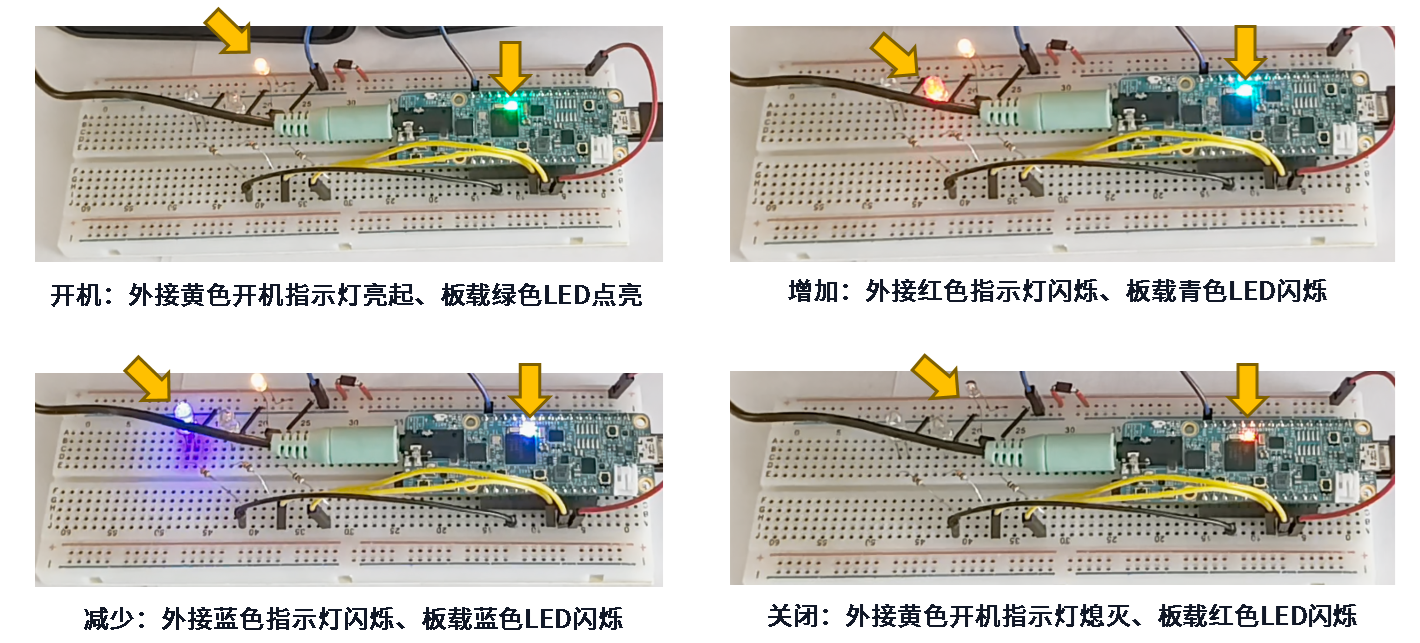
命令词与类别、反馈效果、WAV 文件的完整映射:
命令词 | 模型类别 | LED 颜色与模式 | WAV 文件 |
|---|---|---|---|
开机 | OPEN | 绿色常亮 1s | OPEN.WAV |
增加 | INCREASE | 青色 100ms×5 快闪 | INCR.WAV |
减少 | DECREASE | 品红 250ms×2 闪烁 | DECR.WAV |
关机 | CLOSE | 红色 250ms×2 闪烁 | CLOSE.WAV |
串口同步输出识别记录(格式:KWS,序号,时间戳ms,类别ID,类别名,置信度,proc_ms=处理耗时),可用于量化统计识别准确率与响应时间。
7 遇到的难点及解决方法
难点 1:训练数据量小(单一说话人),易过拟合。
解决:训练集对原始波形做多样化增强——随机增益(±4dB)、白噪声(SNR 18~35dB)、变速扰动(0.92~1.08 倍)、轻度混响,每条录音生成 4 份增强副本。
难点 2:识别与 WAV 回放共用一条 I2S 音频通路的状态切换。
解决:将反馈过程实现为严格的状态序列——停止 I2S 接收 → 播放 WAV(TX DMA)→ 播放完成关闭 I2S 释放 TX/RX 状态 → 清空音频缓冲 → 复位前端特征历史与后处理平滑窗口 → 重启接收 DMA。PMIC 绿色 LED 与该状态机联动指示"监听/反馈",同时避免回放的语音被自身再次识别造成自触发。
难点 3:中文命令词数据集的采集。
解决:基于同一块开发板编写专用录音采集固件(附录A):按键启停录音、文件按序号自动命名写入 microSD,配合标签区间文件即可批量入库;采集时同时录制噪音样本作为 UNKNOWN 类与增强素材。
8 对本次活动的心得体会
通过本项目完整走通了"嵌入式数据采集 → PC 端模型训练量化 → MCU 端 CMSIS-NN 部署"的边缘 AI 全流程,收获主要有三点:
- CodeFusion Studio 的开发体验:CFS 把外设配置(时钟树、I2S、DMA、GPIO)图形化并自动生成初始化代码,构建/烧录/调试在同一个 IDE 内完成,配合 UART 实时日志,调试"音频流 + 神经网络"这类多模块协同的固件效率很高;对 CMSIS-NN/CMSIS-DSP 的集成也让 int8 算子调用非常直接。
- 建议:希望官方后续能提供更多音频类(PDM/I2S codec)与 CMSIS-NN 部署方向的完整例程或文档,降低参赛者在音频链路配置上的摸索成本;另外期待 CFS 的外设配置能覆盖更多第三方库(如 FatFs + SD)的一键集成。
最后,感谢 ADI 与硬禾科技为本项目提供的支持!
附录A 录音数据采集程序(MAX32655-FTHR)
模型的训练数据由 MAX32655-FTHR 开发板自主采集:编写的录音固件将它变成一台"命令词录音机",直接产出到 microSD 卡的 WAV 数据集,省去 PC 录音工具与格式转换环节,且采集链路与部署固件的音频链路(同一颗 MAX9867、同样的 16kHz/16bit 配置)完全一致,从源头保证训练数据与推理输入同分布。
工作流程:
状态 | 触发 | 现象 |
|---|---|---|
就绪 | 上电挂载 SD 卡成功 | 绿色 LED1 常亮,等待按键 |
录音 | 按下 SW3(经 MAX6817 连接 P0.3) | 红色 LED0 点亮,音频流式写入 SD 卡 |
停止 | 再次按下 SW3 | 写完 WAV 文件头,进入回放 |
回放 | 自动 | 蓝色 LED2 点亮,录完即回放试听 |
技术要点:
- 音频链路与识别固件一致:板载数字麦克风 → MAX9867(I2C 0x18,MCLK 12.288MHz,右通道,ADC +3dB)→ I2S RX DMA 双缓冲(每块 2048 样本 = 128ms),边录边写卡;
- 文件格式:16kHz / 16bit / 单声道标准 RIFF WAV;
- 文件命名:
REC0000.WAV、REC0001.WAV……自动扫描寻找空闲序号,避免覆盖; - 存储:microSD(SPI 400kHz 初始化、5MHz 运行)+ FatFs 文件系统,流式
f_write写入; - 串口同步打印文件名、字节数、时长与峰值电平,方便监控削波等质量问题。

采集的数据集(16kHz 单声道):
命令词 | 录音编号区间 | 条数 | 模型类别 |
|---|---|---|---|
开机 | REC0000 ~ REC0069 | 70 | OPEN |
关机 | REC0070 ~ REC0139 | 70 | CLOSE |
增加 | REC0140 ~ REC0209 | 58 | INCREASE |
减少 | REC0210 ~ REC0279 | 70 | DECREASE |
环境噪音(拒识样本) | REC0280 ~ REC0309 | 30 | UNKNOWN |
数据集按 60%/20%/20% 划分为训练/验证/测试集(固定随机种子保证可复现);数据管线另按约 20% 比例合成静音样本作为 SILENCE 类。
由于数据集协议原因,完整音频数据集不公开。如有需要,请使用录音采集固件,自行构建数据集。
附录B 模型训练与导出使用方式
训练工程独立于固件工程(PC 端,Python 3.8 + PyTorch 2.4.1,纯 CPU 即可完成),在 config.toml 输入数据集命令词的编号范围后,依次执行以下指令:
# 1. 生成数据清单(按标签区间 + 数据集划分)
python -m scripts.build_manifest --config config.toml

# 2. 训练 float32 模型(早停)
python -m scripts.train --config config.toml

# 3. 校准 float 模型判决阈值
python -m scripts.calibrate --config config.toml

# 4. 量化感知训练(int8 QAT 微调)
python -m scripts.qat --config config.toml

# 5. 在整数参考路径上重新校准逐类阈值(部署到开发板后,要手动微调)
python -m scripts.calibrate_int8 --config config.toml

# 6. 验证 float / 伪量化 / 整数参考三方一致性
python -m scripts.verify_export --config config.toml

# 7. 导出 CMSIS-NN C 代码到固件工程(kws/generated 目录)
python -m scripts.export_cmsis --config config.toml --firmware-generated-dir ..\test1\m4\kws\generated
导出产物(自动生成,固件直接编译使用):
文件 | 内容 |
|---|---|
| int8 权重、int32 偏置、逐通道 multiplier/shift、类别名表 |
| Hann 窗、32 频带 Mel 滤波器组(稀疏存储)、特征均值/方差、输入量化参数 |
| 类别数、输入尺寸、各层形状/步长/填充、SRAM arena 尺寸、推理间隔等全部宏 |
| 层清单、量化参数、flash/SRAM 占用估算、CRC 与部署门禁结果 |
训练指标可视化结果:

 john重光一两风
