
基于 MAX32655FTHR 的离线关键词识别与 BLE 智能语音终端
1. 所选任务和项目描述
所选任务:题目 2——关键词唤醒与命令词识别。
任务要求使用板载 PDM 麦克风,实现 3~5 个预设关键词的离线识别,识别响应延迟控制在 500 ms 以内,并在串口和屏幕显示识别结果。
本项目分为两个递进阶段:
- 基础任务工程:在 MAX32655 Cortex-M4 上运行 Edge Impulse DSCNN 模型,完成真正的板端离线关键词识别;当前应用从模型的 35 个输出中筛选
yes、no、up、down、stop、go六个命令,可按任务要求保留其中 3~5 个。 - 功能扩展工程:复用同一套板载麦克风、MAX9867 和 I2S/DMA 音频链路,增加 BLE 音频传输、Windows 离线中文命令识别、快捷键控制、Codex 额度显示以及 LVGL 图形界面。
项目描述:
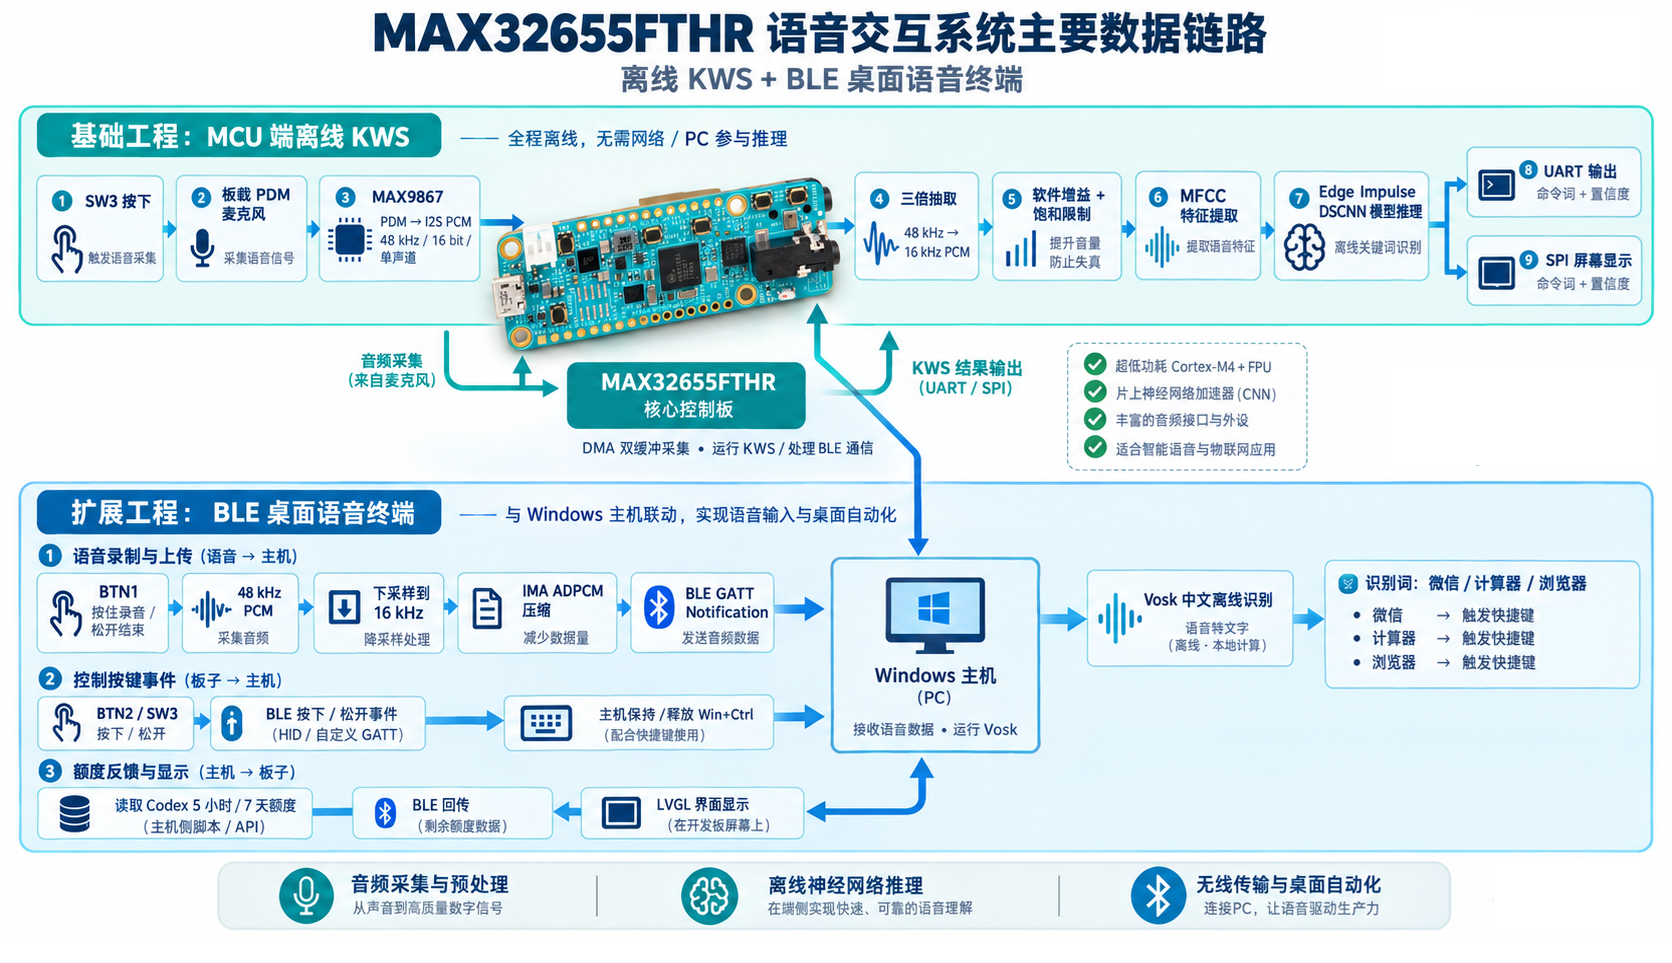
本项目基于 MAX32655FTHR 实现完整的嵌入式语音交互链路:通过 PDM 麦克风和 MAX9867 获取 48 kHz 音频,利用 DMA 采集后下采样至 16 kHz,并完成增益、MFCC 特征提取和 DSCNN 离线关键词识别,结果通过 UART 和 LVGL 屏幕显示;在此基础上进一步加入 IMA ADPCM 音频压缩和 BLE GATT 通信,将语音传输至 Windows 进行 Vosk 离线识别并触发桌面快捷操作,同时支持按键事件和 Codex 额度信息在主机与开发板之间双向传输。
2. 硬件介绍
2.1 MAX32655FTHR 开发板
MAX32655FTHR 的主控为 MAX32655。本项目主要使用其 Cortex-M4 内核、I2S、I2C、DMA、SPI、UART 和 BLE 5.2 控制器,其中基础 KWS 模型运行在 Cortex-M4 上,系统主频配置为 100 MHz。各外设分别承担音频采集、数据搬运、屏幕与串口通信以及无线传输等任务,配合片上资源完成从语音输入、信号处理到识别结果输出的完整流程。
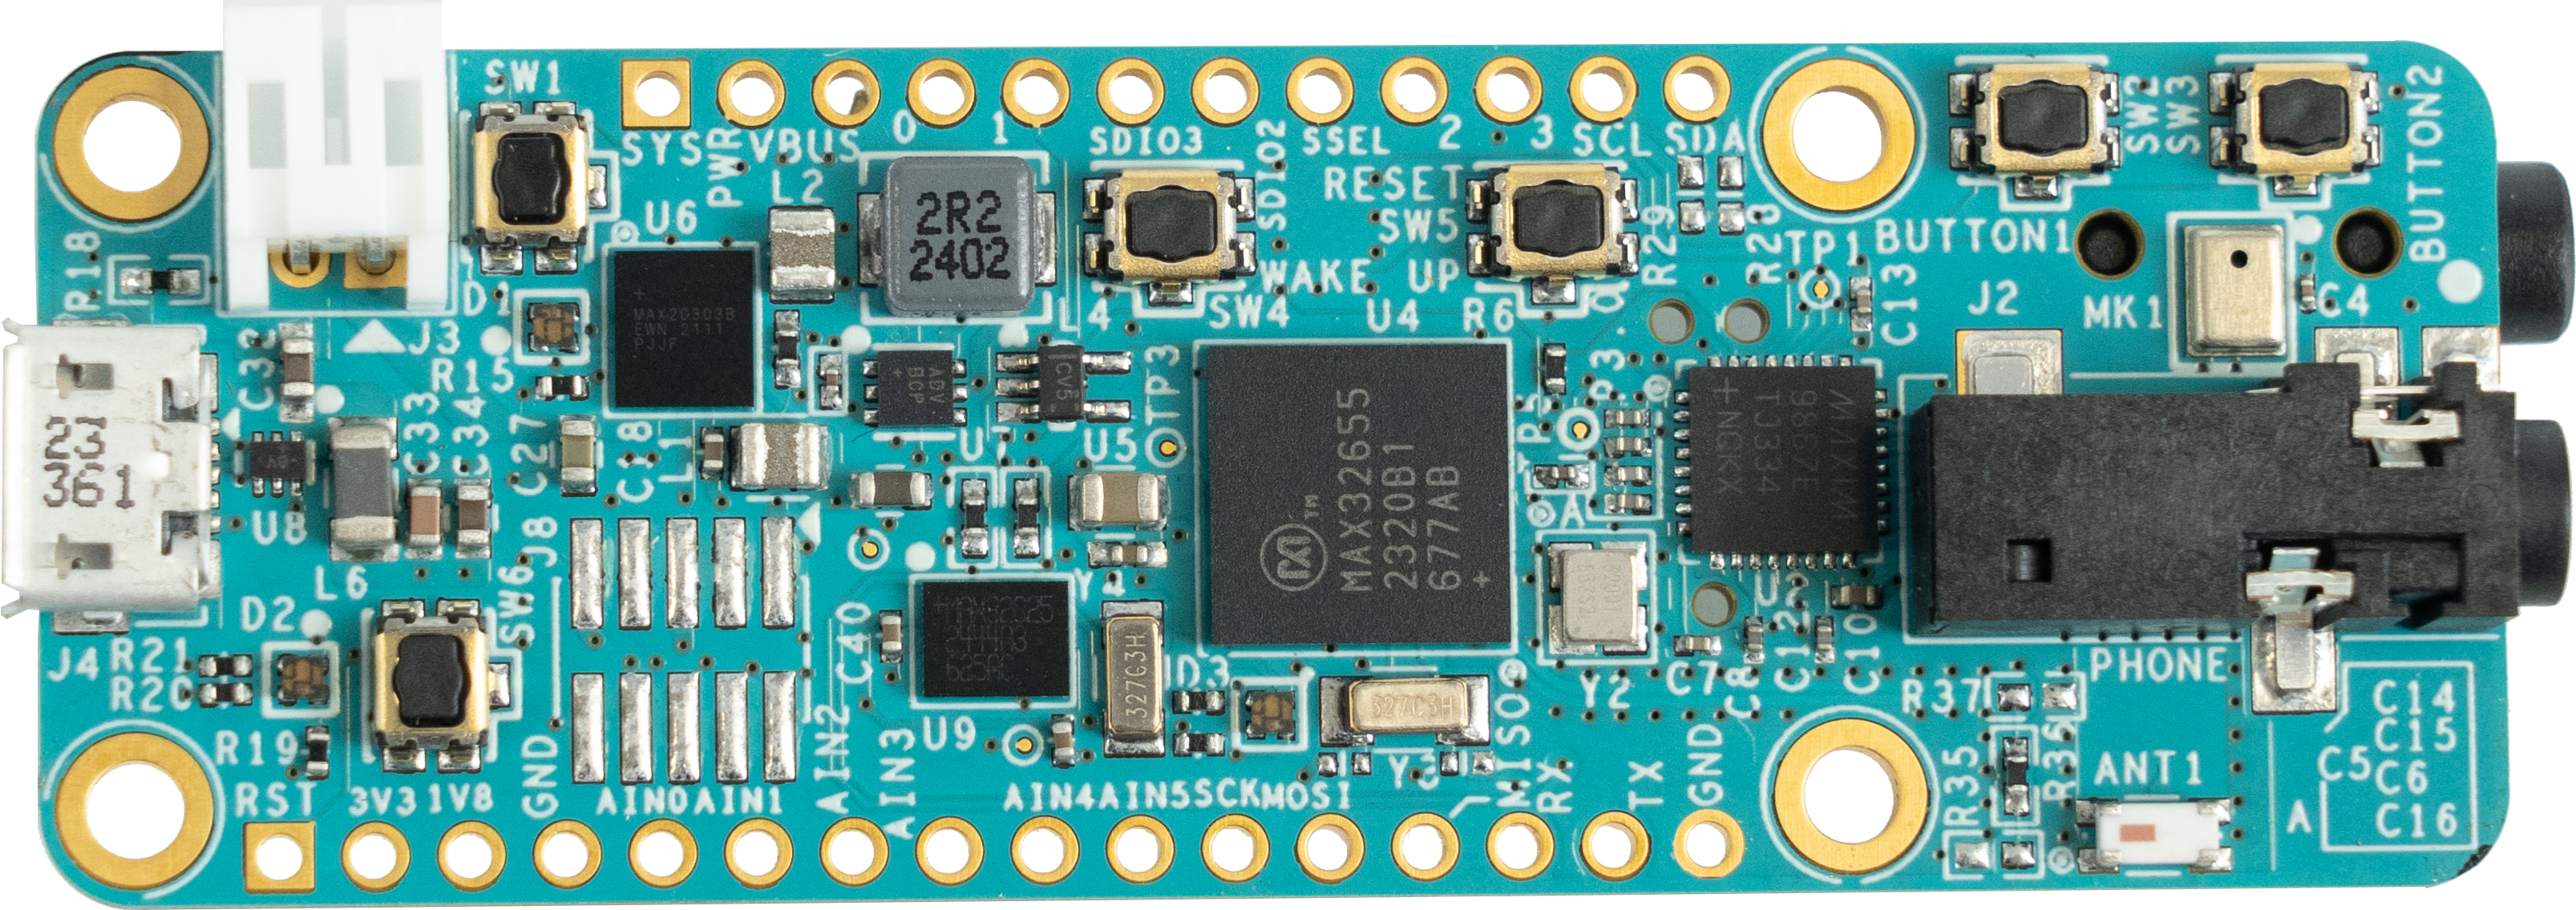
MAX32655实物图
2.2 板载 PDM 麦克风与 MAX9867
板载 Knowles SPH0644 是一颗数字 PDM MEMS 麦克风,具有体积小、数字输出、抗模拟链路干扰能力较强等特点,主要负责前端语音采集;MAX9867 则承担音频编解码与接口转换,将麦克风音频整理为 MAX32655 可直接处理的 I2S PCM 数据。实际工程中,MAX9867 通过 I2C1进行寄存器配置,配置12.288 MHz 音频主时钟,最终输出 48 kHz、16 bit、单声道右声道 PCM。MAX32655 采用 DMA 进行连续音频搬运,每个 DMA 块包含 480 个采样点,对应约 10 ms 音频,为后续下采样、MFCC 特征提取和关键词识别提供稳定的数据输入。
2.3 SPI 彩色屏幕
外接屏幕为 ST7735S 兼容的 128×160 RGB565 屏幕。基础工程使用轻量级点阵字体直接绘制,扩展工程使用 LVGL 8.3 构建界面。
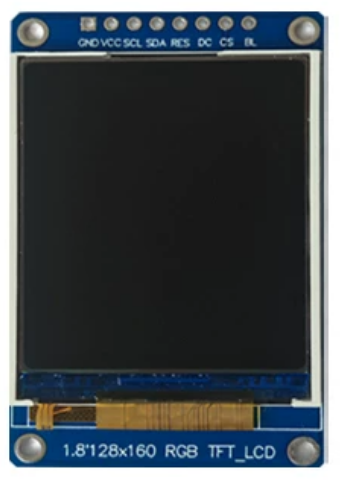
屏幕信号 | MAX32655 引脚 | 说明 |
|---|---|---|
SCK | P0.23 | SPI1 时钟 |
MOSI | P0.21 | SPI1 数据输出 |
CS | P0.20 | GPIO 片选 |
DC | P2.0 | 命令/数据选择 |
RST | P2.3 | 屏幕复位 |
BL | P2.2 | 背光控制 |
3. 方案框图与设计思路
3.1 基础任务方案框图
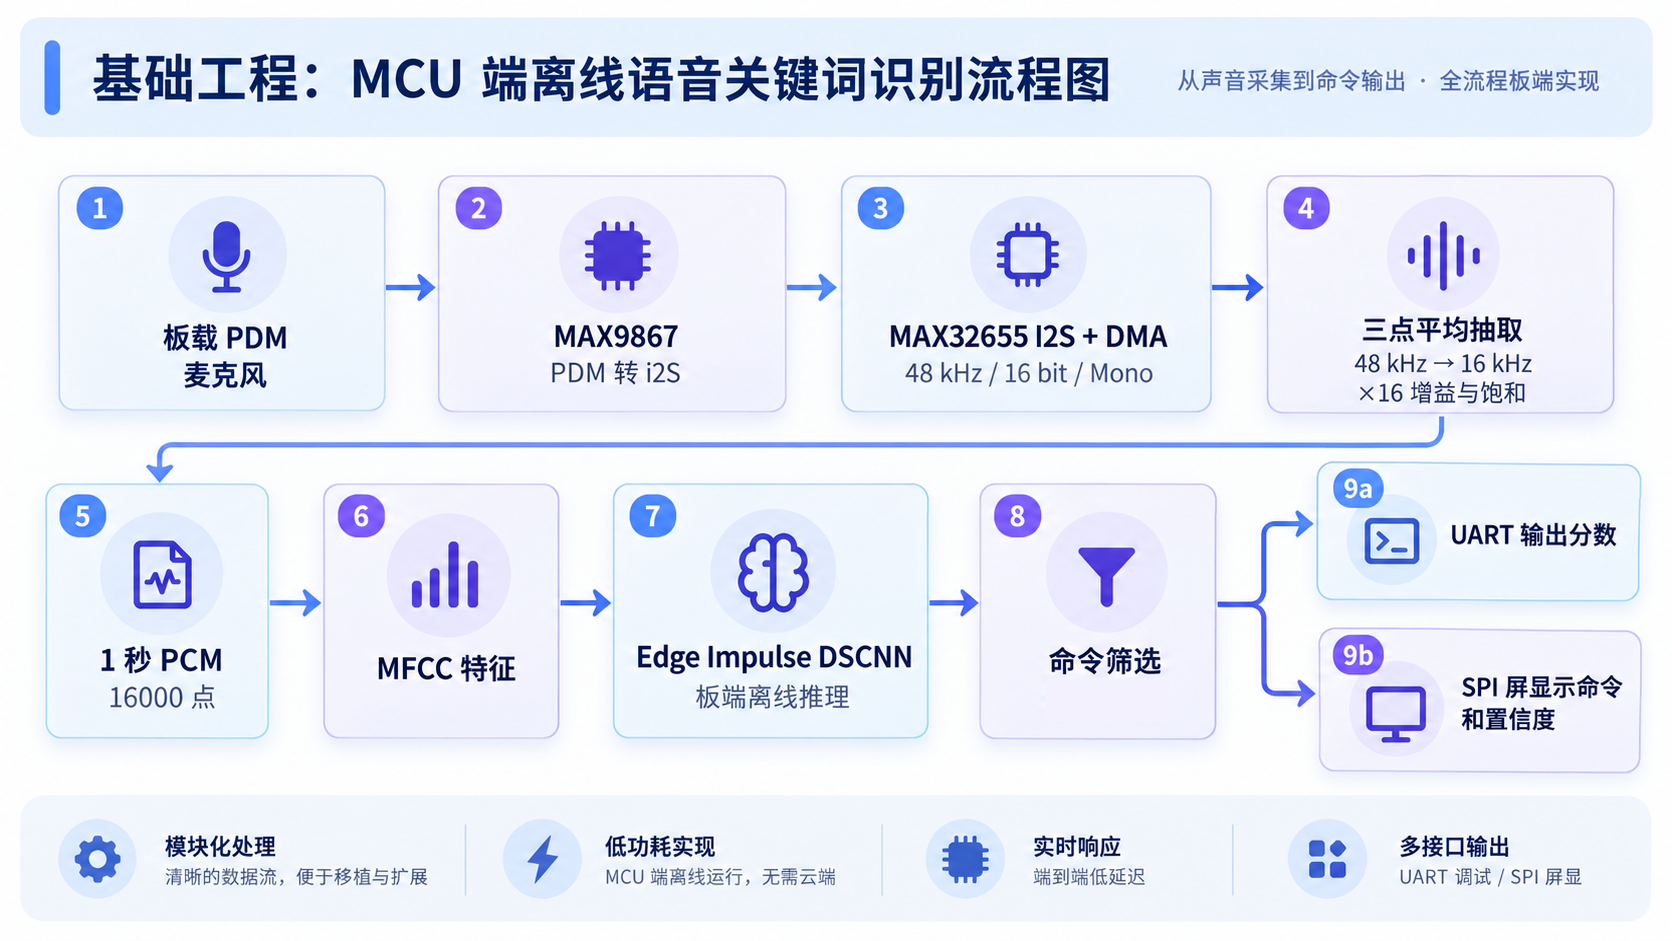
用 DMA 采集代替逐点轮询,降低 CPU 搬运音频的负担;使用两个 480 点缓冲区交替接收,减少块与块之间的丢样风险;三个 48 kHz 样本求平均后抽取一个样本,使采样率匹配 16 kHz 模型;使用软件增益补偿板载麦克风幅度偏低,同时做 int16_t 饱和保护;神经网络保留 35 类输出,应用层只允许预设命令超过阈值后生效;识别结果同时输出到串口和屏幕,便于演示及故障定位。
3.2 扩展系统方案框图
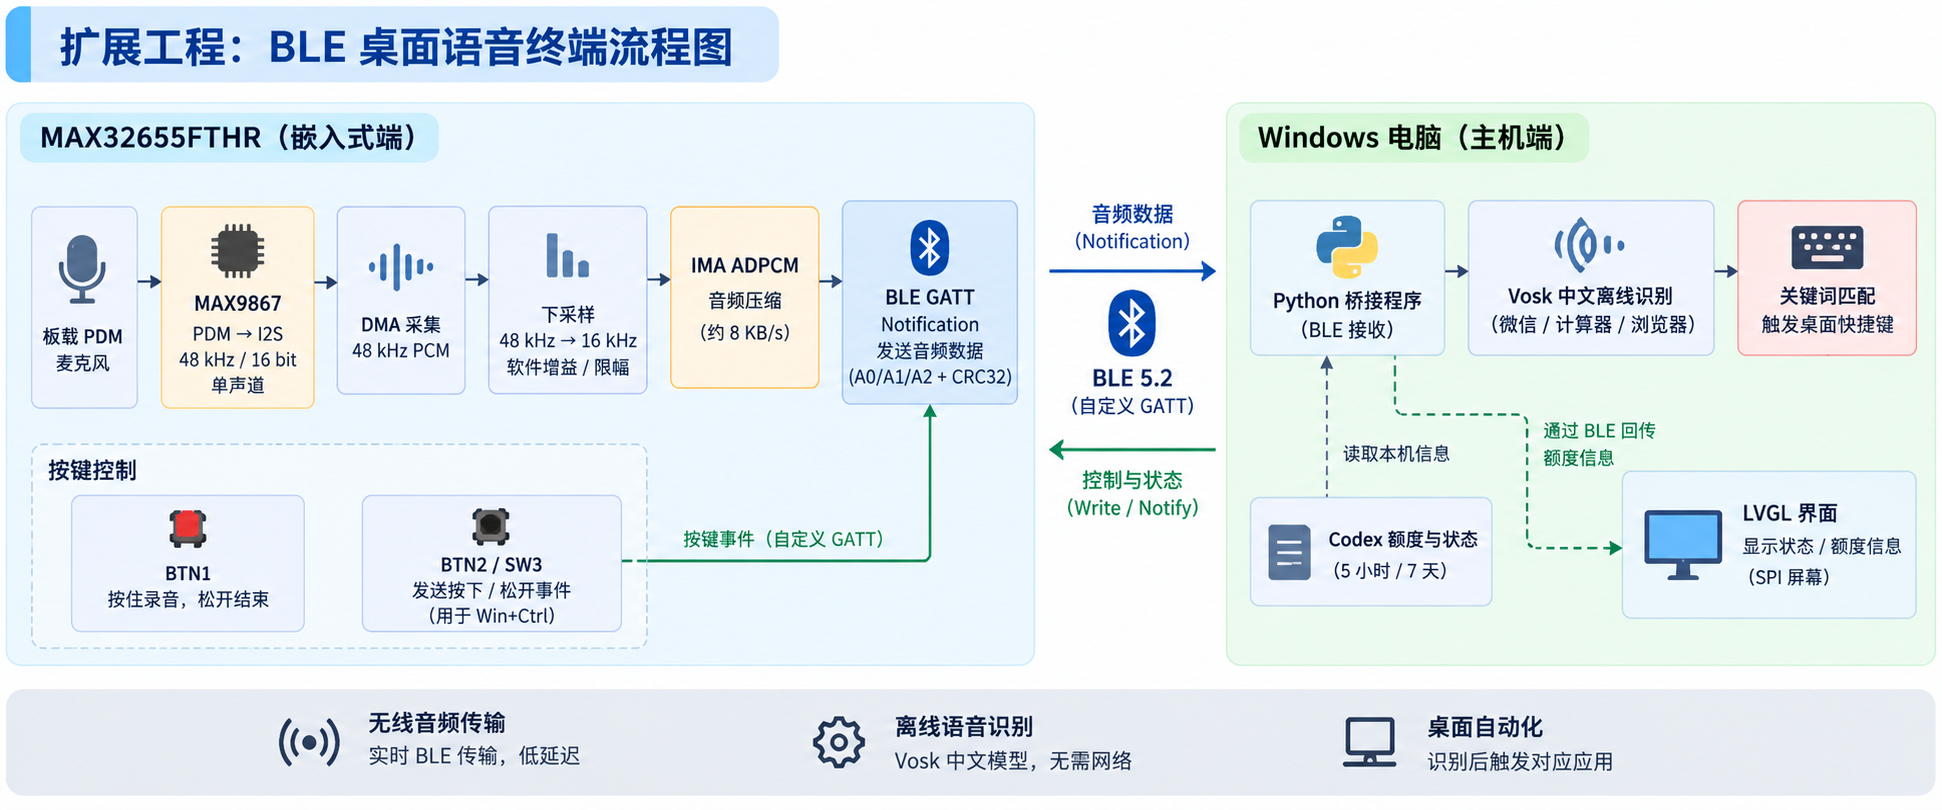
扩展方案没有把长音频原始 PCM 直接发送,而是先在板端编码为 4 bit IMA ADPCM,将 16 kHz、16 bit PCM 的约 32 KB/s 降低到约 8 KB/s。每包带连续偏移,整段带长度和 CRC32,主机验证完整后才进行识别。
3.3 软件整体流程框图
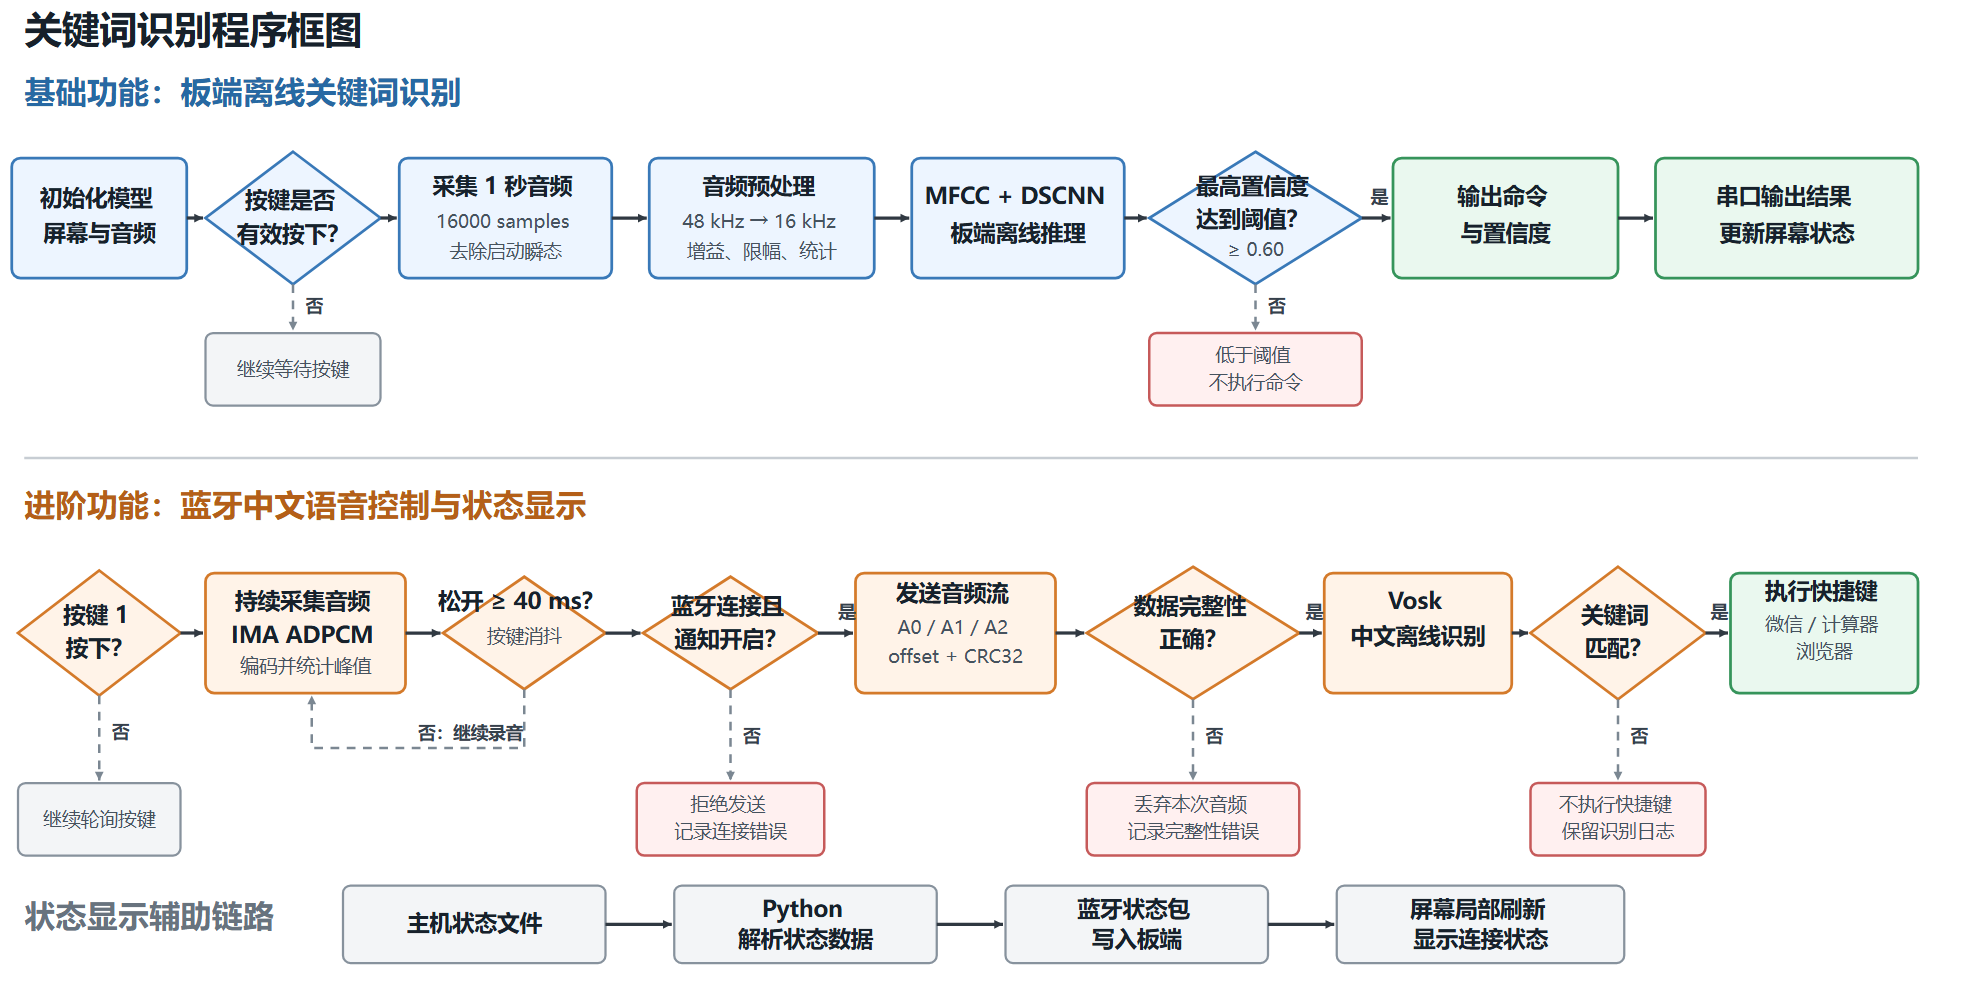
整体软件流程分为基础和进阶两部分:基础部分由开发板完成离线关键词识别,系统初始化后等待按键触发,采集音频并完成下采样、增益处理、MFCC特征提取和DSCNN模型推理;当识别置信度达到阈值时,在串口和屏幕显示命令,否则不执行操作。进阶部分在此基础上实现按键录音、IMA ADPCM压缩和BLE传输,主机对接收到的音频进行完整性校验后,使用Vosk离线识别中文命令并执行对应Windows快捷键;同时主机将Codex额度和运行状态通过BLE回传,开发板使用屏幕实时显示状态。
4. 软件功能实现
4.1 ADI Codefusion Studio 使用
本项目使用 ADI CodeFusion Studio 和 MSDK 完成 MAX32655FTHR 的工程配置、交叉编译、烧录和串口调试。程序运行在 MAX32655 的 Cortex-M4 核上。图中展示了项目在 ADI CodeFusion Studio 中的工程结构和 MAX32655 引脚配置界面。左侧为工程文件:
.cfs:保存工作区、芯片和调试配置;
src:存放音频采集、模型推理、屏幕及 MAX9867 驱动;
edge-impulse-sdk:Edge Impulse 推理库;
model-parameters 和 tflite-model:DSCNN 模型参数及模型文件;
build:保存编译生成的 ELF 固件。
右侧 System Planner 用于查看 MAX32655 的 GPIO、I2C、I2S、SPI、UART 和 BLE 等资源,完成引脚分配并检查复用冲突。本项目主要配置 I2C1 和 I2S 采集音频、SPI1 驱动屏幕、UART0 输出调试信息。配置完成后,CodeFusion Studio通过 MSDK 和 arm-none-eabi-gcc 编译程序,并利用 GDB、OpenOCD 和 CMSIS-DAP 将固件烧录到开发板

4.2 板端DSCNN离线模型实现
本项目使用 Edge Impulse 平台完成关键词识别模型的训练、优化和嵌入式部署。平台首先对语音数据进行切分和标注,再提取 MFCC 特征,最后训练适合微控制器运行的 DSCNN(深度可分离卷积神经网络)模型。使用的是已有数据集Google Speech Commands 可以识别常用的35个关键词,准确率达到80.24%。

模型处理流程如下:
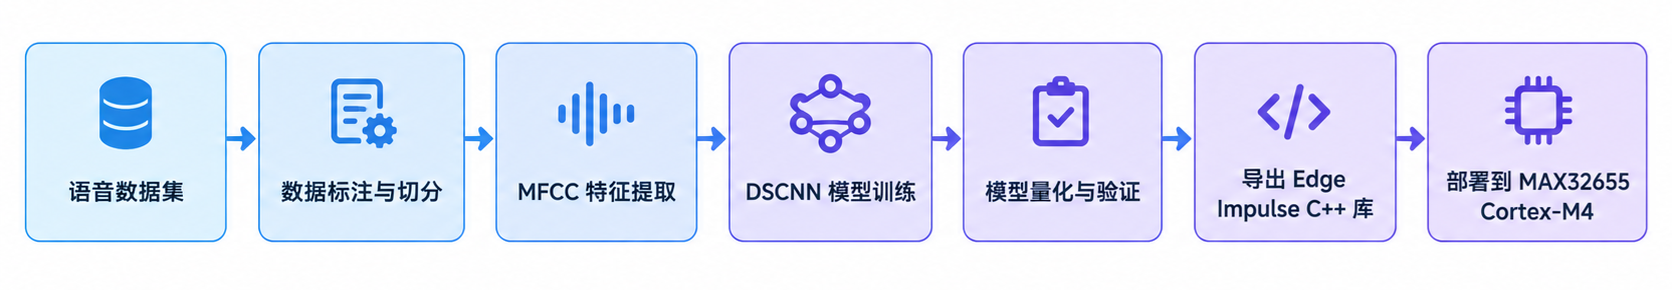
DSCNN 使用深度卷积和逐点卷积代替普通卷积,在保持识别能力的同时减少模型参数量、运算量和内存占用,适合 MAX32655 等资源有限的嵌入式设备。导出的 Edge Impulse 工程主要包括:
目录 | 作用 |
|---|---|
| MFCC处理、分类器和TFLite Micro运行库 |
| 采样率、输入长度和类别信息 |
| 训练并转换后的DSCNN模型 |
| 模型与C语言主程序之间的接口 |
程序通过 signal_t 向 Edge Impulse 提供音频数据,并调用 run_classifier() 完成本地推理:
signal_t signal;
signal.total_length = count;
signal.get_data = &ei_kws_get_data;

ei_impulse_result_t result = { 0 };

EI_IMPULSE_ERROR err =
    run_classifier(&signal, &result, false);
模型输出每个类别的置信度,程序将结果保存到数组中:
for (size_t i = 0; i < EI_CLASSIFIER_LABEL_COUNT; i++) {
    out[i].label =
        ei_default_impulse.impulse->categories[i];

    out[i].value =
        result.classification[i].value;
}
当前模型包含35个语音类别,应用层只选择需要的命令词,并从中寻找最高置信度:
static const char *const command_labels[] = {
    "yes", "no", "up", "down", "stop", "go"
};

static const uint8_t command_model_indices[] = {
    33U, 18U, 30U, 5U, 26U, 11U
};
最高分需要达到设定阈值才认为识别成功:
#define COMMAND_CONFIDENCE_THRESHOLD 0.60f

if (kws_results[best].value <
    COMMAND_CONFIDENCE_THRESHOLD) {
    printf("=> no command\n");
} else {
    printf("=> detected: %s (%.3f)\n",
           command_labels[command],
           (double)kws_results[best].value);
}
采用置信度阈值可以减少环境噪声和非目标语音造成的误触发。整个 MFCC 特征提取和 DSCNN 推理过程均在 MAX32655 Cortex-M4 上离线完成,不依赖网络或云端服务器,具有响应快、隐私性好和断网可用等特点。
4.3 关键外设驱动和蓝牙协议实现
MAX9867与I2S音频接口
MAX9867通过I2C1进行配置,并向MAX32655输出48kHz、16bit PCM音频。I2S使用DMA接收数据,减少CPU占用。
i2s_request.wordSize   = MXC_I2S_WSIZE_HALFWORD;
i2s_request.sampleSize = MXC_I2S_SAMPLESIZE_SIXTEEN;
i2s_request.channelMode =
    MXC_I2S_EXTERNAL_SCK_EXTERNAL_WS;
i2s_request.stereoMode = MXC_I2S_MONO_RIGHT_CH;

MXC_I2S_Init(&i2s_request);
MXC_I2S_RegisterDMACallback(i2s_dma_callback);

max9867_init(MXC_I2C1, 12288000, 48000);
DMA完成后由中断回调通知主程序处理当前音频块:
static void i2s_dma_callback(int handle, int error)
{
    (void)handle;
    (void)error;
    i2s_dma_done = true;
}
SPI屏幕与按键
屏幕使用SPI1硬件接口,工作频率为8MHz。DC、RST、CS和背光由GPIO控制,LVGL负责绘制识别状态、BLE状态和额度信息。
#define DISPLAY_SPI       MXC_SPI1
#define DISPLAY_SPI_HZ    8000000U
#define DISPLAY_SCK_PIN   MXC_GPIO_PIN_23
#define DISPLAY_MOSI_PIN  MXC_GPIO_PIN_21
#define DISPLAY_CS_PIN    MXC_GPIO_PIN_20
按键采用1ms轮询和40ms消抖。BTN1用于语音采集,BTN2用于发送快捷键按下和松开事件。
#define BUTTON_POLL_MS      1U
#define BUTTON_DEBOUNCE_MS 40U
BLE自定义通信协议
板端使用Cordio BLE协议栈,以 MAX32655-CODEX 为设备名称进行广播。自定义服务包含一个RX写入特征和一个TX通知特征。
#define BLE_DEVICE_NAME         "MAX32655-CODEX"
#define CODEX_OP_STATUS         0x10U
#define CODEX_EVT_VOICE         0x90U
#define CODEX_EVT_AUDIO_START   0xA0U
#define CODEX_EVT_AUDIO_DATA    0xA1U
#define CODEX_EVT_AUDIO_END     0xA2U
通信内容如下:
方向 | 数据 | 作用 |
|---|---|---|
主机→板端 |
| 更新额度、运行状态和重置时间 |
板端→主机 |
| 通知按键按下或松开 |
板端→主机 |
| 发送ADPCM语音数据 |
音频开始包包含采样率、采样点数和编码长度:
start_packet[0] = CODEX_EVT_AUDIO_START;
start_packet[1] = CODEX_AUDIO_FORMAT_IMA_ADPCM_16K;
put_u16(&start_packet[2], 16000U);
put_u32(&start_packet[4], sample_count);
put_u32(&start_packet[8], encoded_bytes);
音频数据包包含当前偏移和ADPCM数据,主机利用偏移检查是否存在丢包:
packet[0] = CODEX_EVT_AUDIO_DATA;
put_u32(&packet[1], audio_stream_offset);

memcpy(&packet[5],
       &audio_stream_data[audio_stream_offset],
       payload_size);
全部数据发送完成后,结束包携带CRC32校验值:
end_packet[0] = CODEX_EVT_AUDIO_END;
put_u32(&end_packet[1], audio_stream_bytes);
put_u32(&end_packet[5], audio_stream_samples);
put_u32(&end_packet[9], ~audio_stream_crc32);
连接建立后,程序请求ATT MTU 247和更大的链路层数据长度,以提高语音传输速度:
AttcMtuReq(connection, 247U);
DmConnSetDataLen(connection, 251U, 2120U);
通过数据偏移、发送确认和CRC32校验,系统能够在提高BLE传输速度的同时保证语音数据的连续性和完整性。
5.项目展示
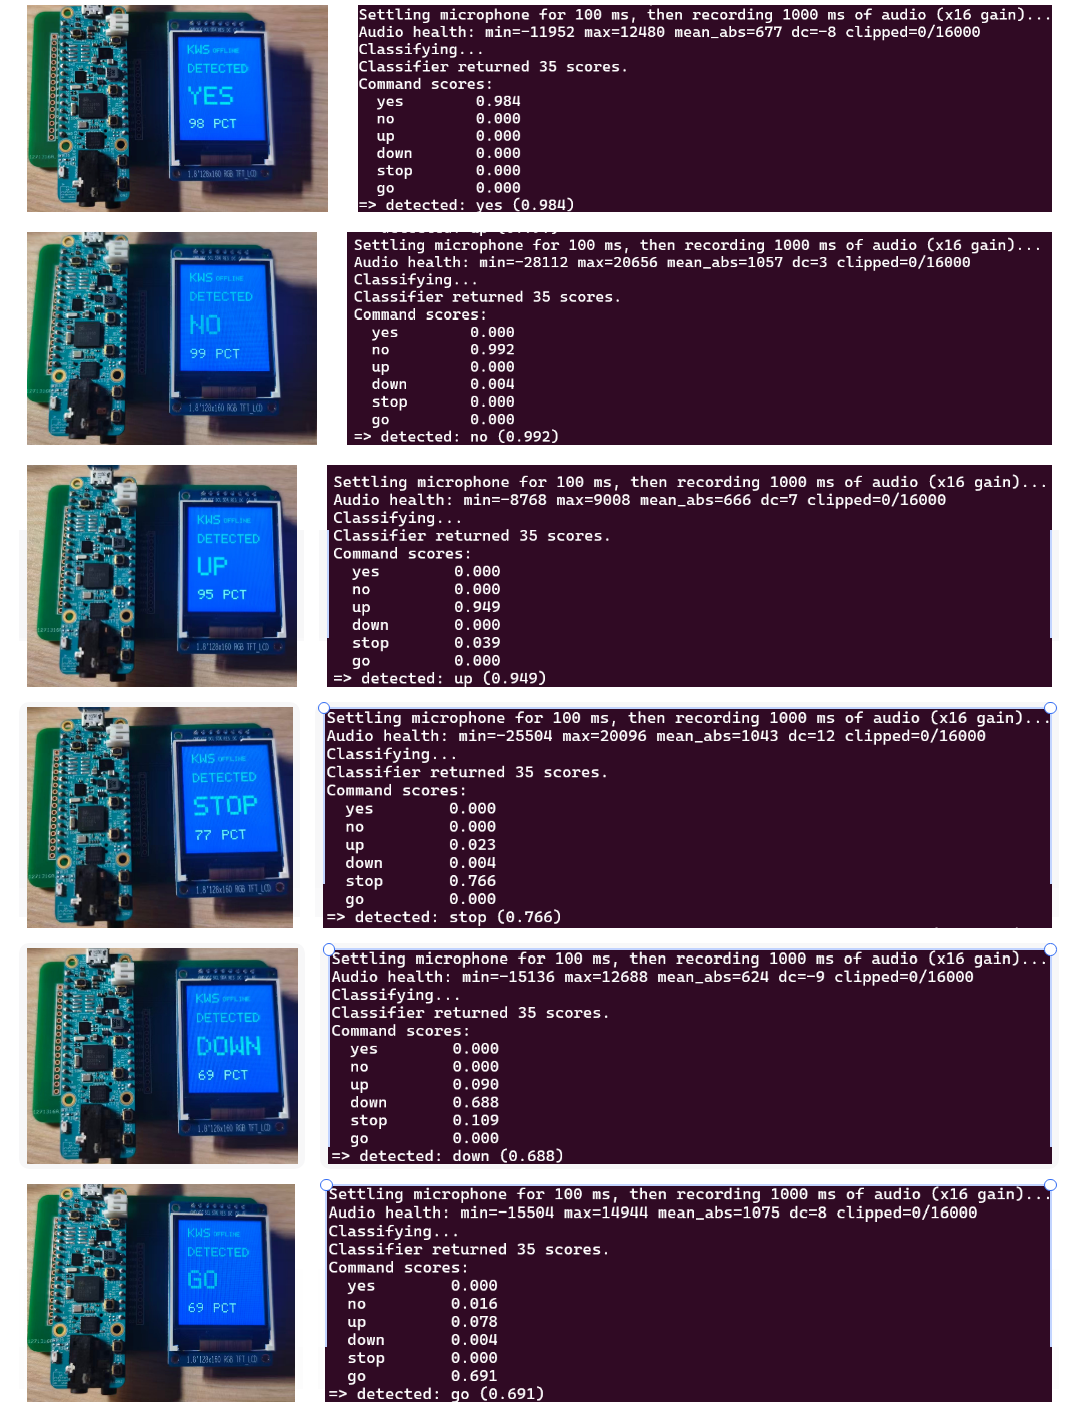
5.1 关键词识别
基于离线语音模型识别的结果如下:
5.2Codex额度显示与语音终端
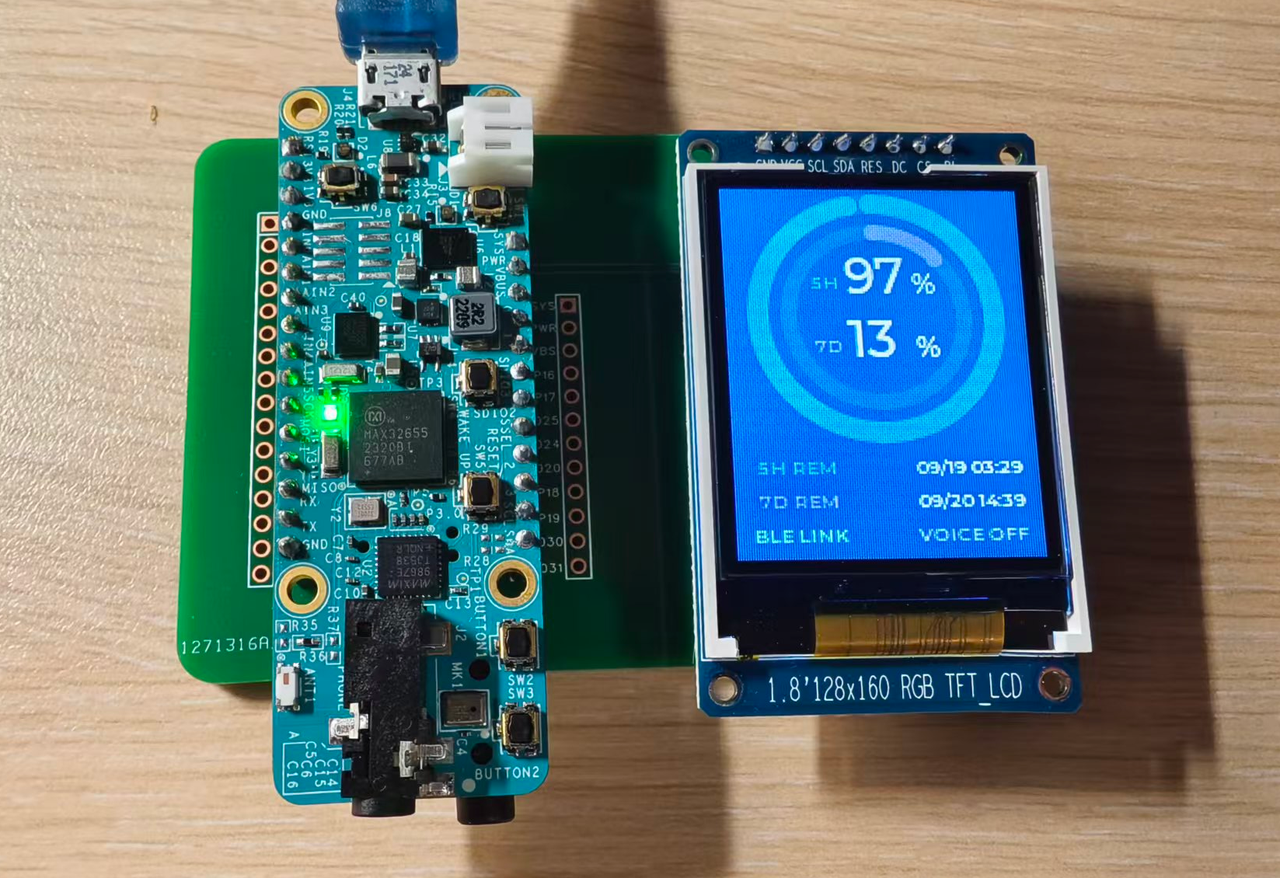
主机运行codex_voice_bridge.py程序后可以在板端看到当前的codex使用额度和更新日期
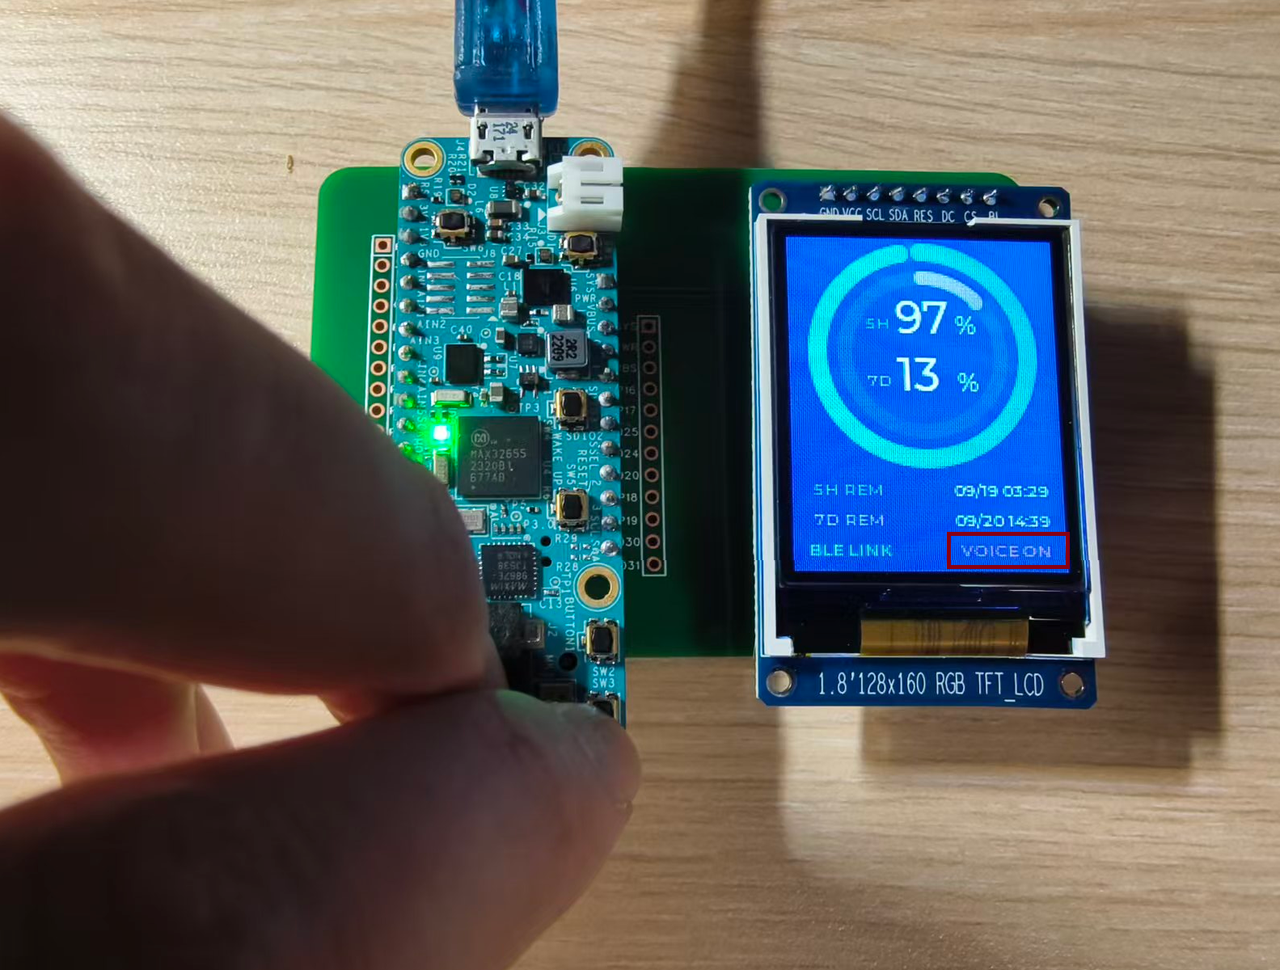
按下BUTTON2可以调用本地的微信快捷语音输入,并且按下期间这里的LVGL会显示 VOICE ON
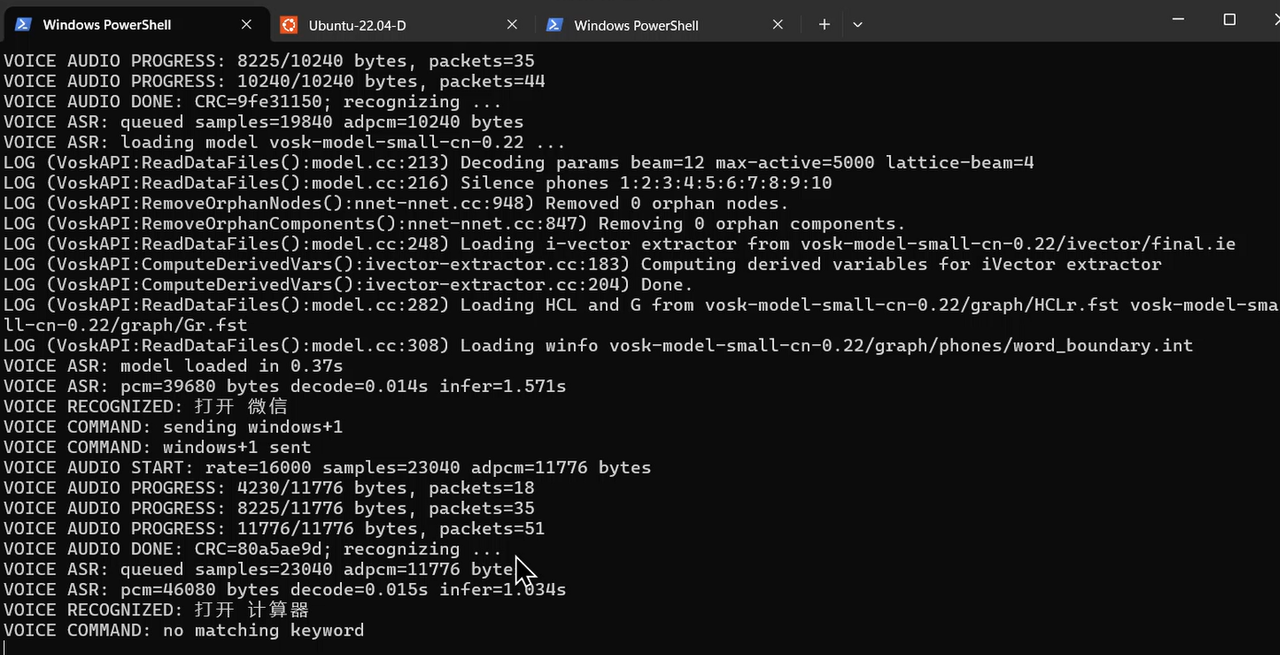
按下BUTTON1可以调用本地的语音识别模型 vosk-model-small-cn-0.22,可以识别中文,可以调用已经预设的快捷指令,打开对应的快捷程序。并且按下期间这里的LVGL会显示 VOICE ON。
6.项目中遇到的难题及解决方法
- 麦克风采集的声音幅度过小
问题描述:板载PDM麦克风采集到的PCM数据幅度较小,导致模型无法稳定识别关键词。
解决方法:对下采样后的音频增加软件增益,并进行16bit饱和限制。同时通过串口输出峰值和削波数量,防止增益过大造成失真。
- 音频采样率与模型输入不一致
问题描述:MAX9867输出48kHz音频,而Edge Impulse模型要求输入16kHz音频,不能直接进行推理。
解决方法:将连续三个48kHz采样点求平均,转换为一个16kHz采样点,使音频格式满足模型要求。
- BLE音频传输速度慢且容易出现数据不连续
问题描述:直接传输PCM音频数据量较大,连续发送通知包时容易出现速度慢、丢包或断开连接。
解决方法:使用IMA ADPCM将音频压缩到原来的约四分之一,并协商ATT MTU 247。数据包中增加偏移地址和CRC32校验,保证音频传输的连续性和完整性。
7.心得体会
- 音频预处理会直接影响识别效果
本项目让我认识到,模型准确率不仅取决于神经网络,还与采样率、音频增益、噪声和削波情况密切相关。只有先保证输入音频质量,模型才能获得稳定的识别结果。
- 分层调试可以提高开发效率
开发过程中通过串口分别检查麦克风初始化、音频采集、模型推理和BLE传输状态,可以快速定位问题所在。将复杂系统拆分为多个可独立验证的模块,是嵌入式开发中非常重要的方法。

 john重光一两风
